VR Prosodic Speech Analysis System
Ein fertiges System, das die Sprechweise während einer VR-Übung misst und anhand eigener ruhiger und dringlich gesprochener Referenzaufnahmen bewertet.
Was es ist Ein System, das die stimmliche Erregung während einer VR-Übung misst und in Echtzeit einen persönlich normierten Score anzeigt.
Was ich gebaut habe Die Python-Engine für die Analyse und der FastAPI-Dienst, den die VR-Schicht aufruft.
Meine Rolle
Ich habe die Python-Engine für die Analyse entworfen und geschrieben. Dazu gehören die Aufnahme, Transkription und Wortzeitstempel mit Faster-Whisper, die Auswertung prosodischer Merkmale mit Praat und librosa, die persönliche Kalibrierung anhand zweier Referenzen, die Score-Berechnung, die Qualitätsprüfungen und die Sitzungsprotokolle. Auch den FastAPI-Dienst, den die VR-Schicht aufruft, habe ich geschrieben. Jeder Commit im Repository ist von mir. Das System läuft von Anfang bis Ende auf einem einzigen Windows-PC, mit dem Headset über Quest Link.
01
Messen, wie jemand spricht
Wie jemand während einer VR-Übung spricht, verrät etwas, das der reine Aufgabenscore nicht erfasst.
Wenn jemand in VR eine simulierte Prozedur durchgeht, weiß das System bereits, ob die Schritte erledigt wurden. Es weiß nichts darüber, wie die Person dabei geklungen hat. Tonhöhe, Lautstärke, Tempo und Pausen liefern diese Information. Ich wollte daraus eine Zahl machen, während die Übung noch läuft.
Eine feste Schwelle funktioniert nicht. Wenn ich sage, alles über 180 Hz oder 70 dB gilt als erhöht, misst das System am Ende die Person statt ihren Zustand. Wer von Natur aus laut spricht, überschreitet diese Linie schon im ruhigen Zustand. Wer leise spricht, überschreitet sie selbst unter echtem Druck nie. Eine feste akustische Schwelle müsste auf unterschiedliche Stimmen passen. Ich wollte aber eine Veränderung innerhalb derselben Stimme erkennen.
- Hardware Ein Windows-PC, Meta Quest 3 über Quest Link, Ton vom virtuellen Oculus-Mikrofon mit 16 kHz mono
- Interaktion Eine Controller-Taste: gedrückt halten zum Aufnehmen, loslassen zum Auswerten
- Grenze Keine Audioanalyse in C# nachgebaut. Eine Umsetzung, in Python
- Latenz Die Auswertung kommt zurück, während die Übung noch läuft
- Grundsatz Lieber nichts zurückgeben als einen schlechten Score
02
Zwei Referenzaufnahmen statt einer festen Schwelle
Jede Person bekommt eine eigene Skala. Beide Endpunkte werden aus ihrer Stimme bestimmt.
Vor der Übung nimmt jede Person zwei kurze Sätze auf. Den ersten spricht sie in normalem Ton als Baseline, den zweiten deutlich dringlicher als Upperline. Der Abstand zwischen den beiden Aufnahmen bildet für jedes Merkmal den persönlichen Bewertungsbereich.
Spätere Aufnahmen werden innerhalb dieses persönlichen Bereichs eingeordnet: null entspricht der Baseline, eins der Upperline. Eine laute und eine leise sprechende Person erhalten denselben Score, wenn sie sich relativ zu ihren eigenen Referenzen gleich stark in Richtung Dringlichkeit verändert haben.
Diagramm: persönliche Kalibrierung
Sprecher A
lauter, höhere Stimmlage
Baseline 112 Hz 0
Upperline 196 Hz 100
Sprecher B
leiser, tiefere Stimmlage
Baseline 78 Hz 0
Upperline 121 Hz 100
Abstand mit Vorzeichen
bei Dringlichkeit langsamer
Baseline 5.4 syll/s 0
Upperline 4.1 syll/s 100
Besonders wichtig war mir, das Vorzeichen der Spanne beizubehalten. Die meisten Menschen sprechen schneller, wenn sie Dringlichkeit ausdrücken; ihre Upperline der Artikulationsrate liegt also über ihrer Baseline. Manche sprechen stattdessen langsamer und bedachter. Die Formel behandelt das nicht als Fehler, der korrigiert werden müsste. Sie behält die Richtung, die diese Person tatsächlich gezeigt hat. Die Spanne ist dann einfach negativ, und der Fortschritt darauf wird genauso berechnet.
app_speech_integrated.py · compare_with_two_anchors()
raw_progress = (
  current_number - baseline_number
) / gap

# Baseline'ın ters yönündeki değişim panik puanı üretmez.
score_progress = max(raw_progress, 0.0)

# Upperline'ı aşmak mümkündür. 1.25 sınırı, tek özelliğin
# bütün skoru aşırı şişirmesini engeller.
score_progress = min(score_progress, 1.25)

weighted_progress += score_progress * weight
used_weight += weight
Fortschritt entlang einer persönlichen Spanne. Negative Spannen funktionieren unverändert, Bewegung in die Gegenrichtung ergibt null, ein Merkmal ist gedeckelt und kann nicht dominieren.
Der Score wird aus sechs Merkmalen berechnet. Jedes hat ein Gewicht und eine Mindestspanne. Die Mindestspanne ist der kleinste Abstand zwischen den beiden Ankern einer Person, der noch als echter Unterschied zählt und nicht als Rauschen.
| Merkmal | Gewicht | Mindestspanne | Quelle |
|---|---|---|---|
| F0-Median | 0.25 | 5 Hz | Praat Tonhöhe |
| Mittlere Intensität | 0.20 | 2 dB | Praat Intensität |
| Artikulationsrate | 0.20 | 0.30 syll/s | Whisper Wortzeitstempel |
| Maximale Intensität | 0.15 | 3 dB | Praat Intensität |
| Tonhöhenumfang (p90−p10) | 0.10 | 5 Hz | Praat Tonhöhe |
| Pausenanteil | 0.10 | 0.03 | Whisper Wortzeitstempel |
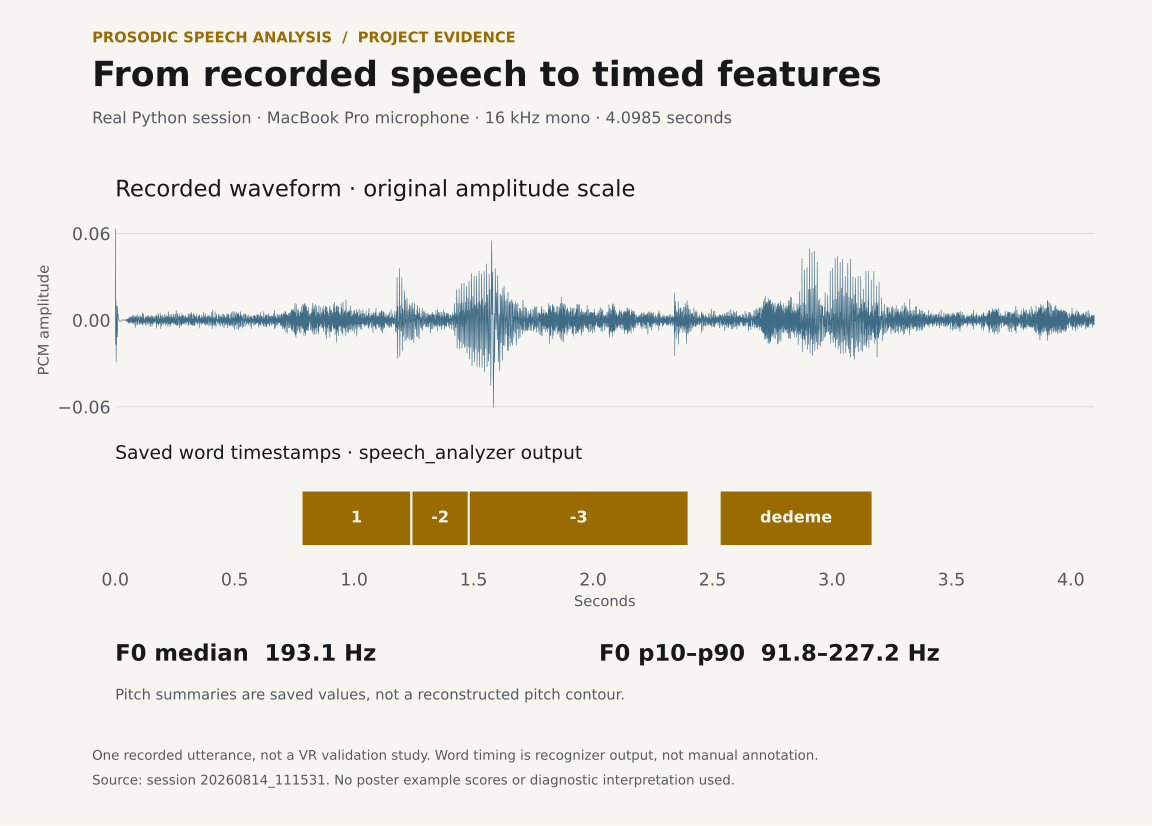
Für die zeitliche Auswertung nutze ich die Wortzeitstempel von Faster-Whisper statt einer energiebasierten Sprachaktivitätserkennung. Energiebasierte VAD kann eine Pause nicht von einem stillen Raum unterscheiden, und ein verrauschtes Signal vom Headset-Mikrofon erschwert die Erkennung zusätzlich. Wortgrenzen aus dem Transkript sind eine deutlich bessere Grundlage dafür, zu sagen, wo das Sprechen tatsächlich aufgehört hat. Silben werden über das Zählen türkischer Vokale genähert. Das ist eine dokumentierte Näherung und kein echter Silbentrenner, und sie reicht, um eine Person mit sich selbst zu vergleichen.
Das System ist bewusst in zwei Schichten gebaut, mit einer HTTP-Brücke dazwischen.
Diagramm: Systemarchitektur
VR-Schicht
Python-Analyse-Engine
- 01 Aufnahme 16 kHz mono
- 02 Transkription · Faster-Whisper
- 03 Prosodische Merkmale extrahieren
- 04 Qualitätsprüfungen
- 05 Persönliche Kalibrierung
- 06 Score 0-100
Läuft auch ohne angeschlossenes Headset
Diese Trennung ist sinnvoll, weil die gesamte Messung in Python bleibt. Zu Praat, librosa und Faster-Whisper gibt es in C# kein Gegenstück. Einen Teil davon in das VR-Projekt zu portieren hätte eine zweite Umsetzung der Messung erzeugt, und ich hätte beide dauerhaft aufeinander abstimmen müssen.
03
Irreführende Scores vermeiden
Ein großer Teil der Entwicklungsarbeit steckt in der Entscheidung, wann kein Ergebnis ausgegeben werden darf.
Einer Zahl auf einem Bildschirm vertraut man schnell. Deshalb muss klar sein, wann das System überhaupt eine ausgeben darf. Die folgenden Prüfungen sind für mich der wichtigste Teil dieser Entwicklung.
Diagramm: Scoring und Qualitätsprüfungen
- 01
Aufnahme brauchbar?
Clipping bei Spitze ≥ 0.99, zu leise unter 0.02, stimmhafte Frames unter 20%
Warnen und die Aufnahme erneut anfordern
- 02
Kalibriersatz gesprochen?
Transkript wird mit dem erwarteten Satz verglichen
Referenzaufnahme wiederholen
- 03
Unterscheidet sich das Merkmal genug?
Baseline und Upperline müssen sich um die Mindestspanne des Merkmals unterscheiden
Das Merkmal aus dem Scoring nehmen
- 04
Bleibt genug vom Profil übrig?
Mindestens zwei Merkmale mit einem Gesamtgewicht von mindestens 0.40
Die Kalibrierung ablehnen
Wenn alle Prüfungen bestanden sind
- Veränderung innerhalb des persönlichen Bereichs, mit der bei dieser Person gemessenen Richtung
- Bewegung entgegen dieser Richtung trägt null bei
- Ein einzelnes Merkmal ist bei 1.25 gedeckelt und kann so nicht dominieren
- Gewichtet, dann auf 0-100 begrenzt
Die Prüfung auf Merkmalsebene ist die wichtigste. Unterscheiden sich Baseline und Upperline bei einem Merkmal nicht ausreichend, liefert es keine Information über die Veränderung dieser Person. Vielleicht hat sie beide Male auf derselben Tonhöhe gesprochen. Dieses Merkmal würde nur Rauschen in die Bewertung bringen. Deshalb wird es ausgeschlossen. Die übrigen Merkmale, bei denen ein Unterschied erkennbar ist, werden neu gewichtet und zum Score verrechnet.
Fallen zu viele Merkmale weg, reicht das Profil nicht mehr für eine Bewertung. Bleiben weniger als zwei Merkmale oder liegt ihr Gesamtgewicht unter 0.40, wird die Kalibrierung abgelehnt. Die Referenzaufnahmen müssen dann wiederholt werden.
Die Aufnahmequalität wird vor all dem geprüft. Clipping bei einer Spitze von 0.99 oder darüber, eine Spitze unter 0.02 oder weniger als 20% stimmhafte Frames lösen jeweils eine Warnung aus. Es gibt noch eine feinere. Meldet die Sprachaktivitätserkennung, dass 98% oder mehr des Fensters aktives Sprechen sind, ist das meist ein lauter Raum, der als durchgehendes Reden gehört wird, und die daraus abgeleiteten Zeitmerkmale sind nicht vertrauenswürdig.
baseline_manager.py · evaluate_recording_quality()
if speech_window > 0:
  active_ratio = active_duration / speech_window

  if active_ratio >= 0.98:
      warnings.append(
          "Kayıdın neredeyse tamamı aktif konuşma olarak algılandı. "
          "Gürültü nedeniyle VAD/sessizlik tespiti güvenilir olmayabilir."
      )
Diese Prüfung soll Raumgeräusche erkennen, nicht die sprechende Person bewerten.
Eine Prüfung mag ich noch besonders. Der Kalibriersatz selbst wird verifiziert: das Transkript dessen, was die Person gesagt hat, wird mit dem Satz verglichen, den sie sagen sollte. Eine Baseline, die aufgenommen wurde, während jemand mit der Person nebenan geredet hat, sollte nicht stillschweigend zur Referenz werden, an der jeder spätere Score gemessen wird.
04
Das fertige System
Vom Tastendruck bis zum Score läuft alles auf einem Rechner.
Das System, von Anfang bis Ende
- Nimmt Ton vom Quest-Mikrofon über Quest Link auf
- Die Controller-Taste steuert
/startund/stopauf der FastAPI-Brücke - Liefert das Transkript und die Wortzeitstempel von Faster-Whisper
- Extrahiert sechs prosodische Merkmale je Aufnahme: F0-Median und Umfang, mittlere und maximale Intensität, Artikulationsrate, Pausenanteil
- Erstellt aus Baseline und Upperline ein persönliches Kalibrierprofil und prüft es vor der Nutzung
- Gibt einen persönlich normierten Score von 0-100 an das VR-Panel zurück
- Schreibt JSON je Äußerung, eine Sitzungs-CSV und einen Sitzungsbericht für spätere Auswertungen
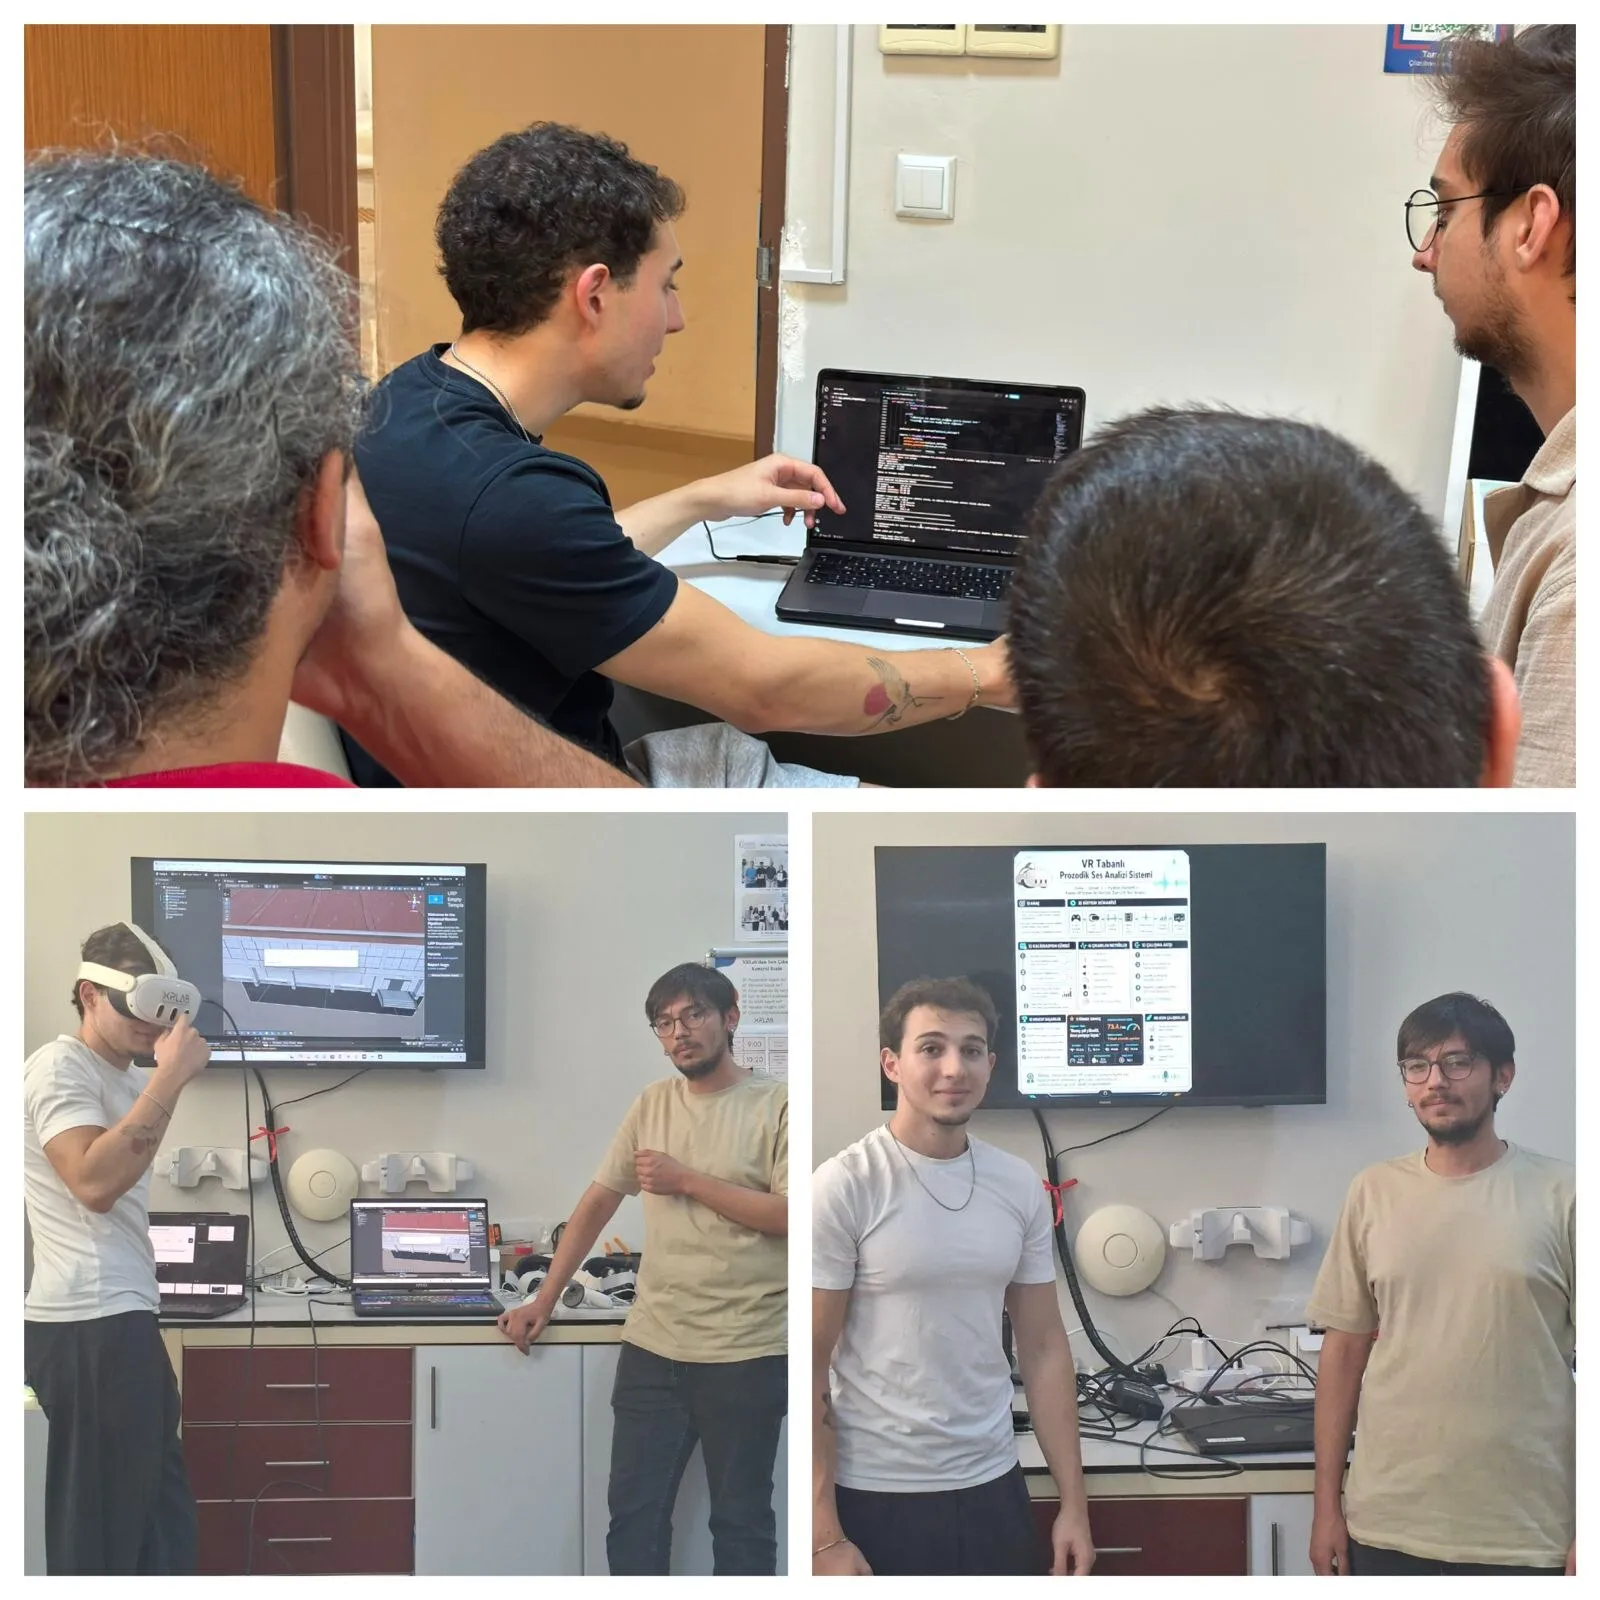
Die Analyse-Engine läuft auch ohne angeschlossenes Headset. So habe ich sie entwickelt und kann sie weiterhin testen: Eine WAV-Datei und ein Satz reichen, um die gesamte Analyse auszuführen. Die VR-Schicht startet nur die Aufnahme und zeigt das Ergebnis an.
Wo die Grenzen liegen
Der prosodische Score zeigt, wie weit sich die Sprechweise von der eigenen ruhigen Referenz in Richtung der dringlichen Referenz verändert hat. Er erklärt nicht, warum. Müdigkeit, eine Erkältung, eine erhobene Stimme in einem lauten Raum und echte Dringlichkeit können dieselben Merkmale in dieselbe Richtung verändern. Das Signal erlaubt keine Unterscheidung zwischen diesen Ursachen. Der Score ist ausdrücklich kein klinisches Maß. Der Code sagt das an der Stelle, an der er ein Ergebnis ausgibt, und ich würde es überall dort weiter sagen, wo das eingesetzt wird. Für die Tempomerkmale wird die Silbenzahl anhand der türkischen Vokale näherungsweise bestimmt. Sie reicht, um eine Person mit sich selbst zu vergleichen, und sie reicht nicht, um Personen untereinander zu vergleichen.
Belege auf dieser Seite: Quellcode · Architektur · Systementwurf