İzmir Reservoir and Water Consumption Forecasting
In einem Team zu viert haben wir zehn Jahre Wasserdaten einer Stadt zu einer Monatstabelle zusammengeführt und daraus die Füllstände der Talsperren prognostiziert.
Was es ist Ein Monatsmodell für Füllstand und Wasserverbrauch in İzmir, gebaut aus zehn Jahren öffentlicher kommunaler und meteorologischer Daten.
Was ich gebaut habe Aufbereitung und Zusammenführung der Daten, Feature Engineering, Modellvergleich und Ergänzung fehlender Wetterdaten, damit die Tabelle nutzbar wurde.
Meine Rolle
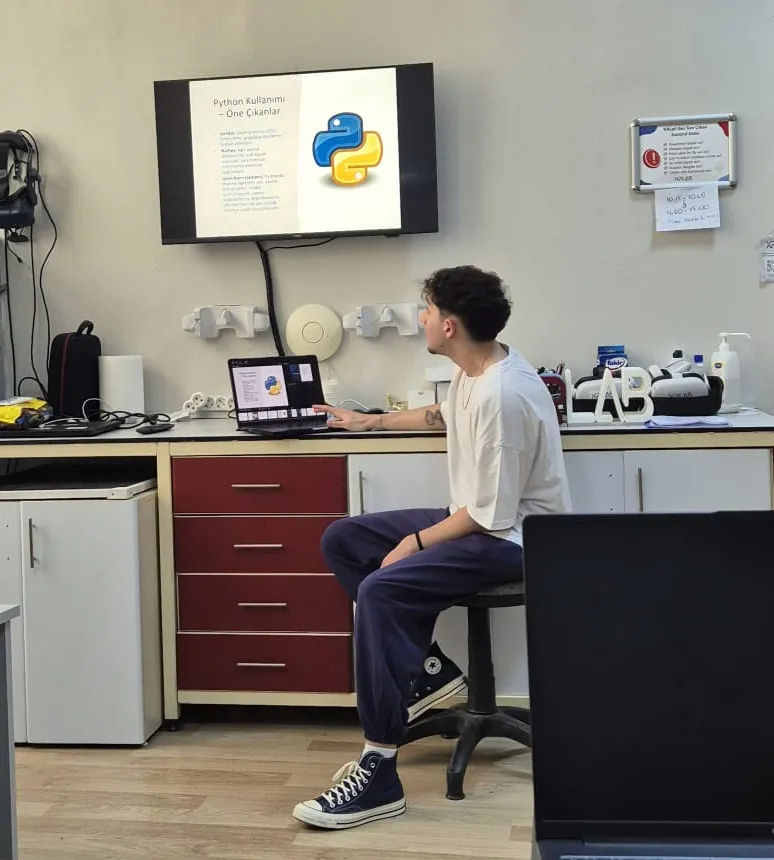
Wir haben das Projekt zu viert umgesetzt. Bei gemeinsam erledigten Aufgaben spreche ich im Folgenden von "wir". Mein eigener Beitrag waren die Daten und die Modellierung: die Rohreihen bereinigen und aufbereiten, die getrennten Datensätze zu einer Monatstabelle zusammenführen, das Feature Engineering, die Modelle trainieren, vergleichen und bewerten, und die Visualisierung. Ich habe den Code geschrieben, der fehlende Wetterdaten über Meteostat mit echten Stationsmessungen ergänzt. Außerdem habe ich die Abschlusspräsentation vorbereitet und das Projekt präsentiert.
01
Zehn Jahre Wasserdaten, eine Zeile pro Monat
İzmirs Wasserdaten sind öffentlich, aber über verschiedene Quellen, Formate und Zeitintervalle verteilt.
Die Talsperren von İzmir, das Wasser, das die Stadt verbraucht, und das Wetter, das beides beeinflusst, sind öffentlich dokumentiert. Veröffentlicht werden sie von verschiedenen Stellen, in verschiedenen Formaten, in verschiedenen Abständen, und ein Teil steht nur in Tabellen von Jahresberichten statt in direkt nutzbaren Datendateien.
Wir wollten zehn Jahre davon in eine einzige Monatstabelle bringen und sehen, wie gut sich der Füllstand daraus prognostizieren lässt. Mit einer solchen Kennzahl könnte ein Wasserversorger Entscheidungen planen. Wir wollten einen hinreichend kleinen, sinnvoll berichtbaren Prognosefehler und ein Modell, das sich den Menschen erklären lässt, die seine Ergebnisse nutzen.
Den Umfang haben wir bewusst begrenzt. Eine Stadt, ein Jahrzehnt, eine Zeile pro Monat.
- Zeitraum 2015-01 bis 2024-12, 120 Monatszeilen
- Zielgrößen Füllstand der Talsperren (%) und gespeichertes Volumen (m³)
- Eingaben Verbrauch, Förderung, Bevölkerung, Temperatur, Niederschlag, Luftfeuchte, Luftdruck, Wind
- Verbrauchsquellen İZSU-Anschluss- und Verbrauchsdaten, 2014 bis 2024
- Wetterquellen Statistiken des türkischen Wetterdienstes, Lücken aus Meteostat-Stationen gefüllt
Die zusammengeführte Monatstabelle ist öffentlich. Sie wurde von einem Mitglied des Teams auf Kaggle veröffentlicht, und es ist dieselbe Tabelle, aus der die Zahlen auf dieser Seite stammen.
Den Datensatz auf Kaggle ansehen
02
Woher die Zahlen kamen, und woher nicht
Für jede Spalte ist die Quelle dokumentiert. Das war uns beim Aufbau der Tabelle wichtig.
Beim Zusammenführen öffentlicher Zeitreihen muss vor allem ihre Herkunft nachvollziehbar bleiben. Sonst sehen geschätzte, interpolierte und gemessene Werte in einer gemeinsamen Spalte gleich aus. Deshalb haben wir die Quellen direkt in den Daten dokumentiert, statt uns auf unsere Erinnerung zu verlassen. Die Verbrauchszeilen nennen den İZSU-Bericht, aus dem sie stammen, die Wetterzeilen nennen die Station, und die aufgefüllten Monate nennen den Dienst und den Abdeckungszeitraum, aus dem sie gefüllt wurden.
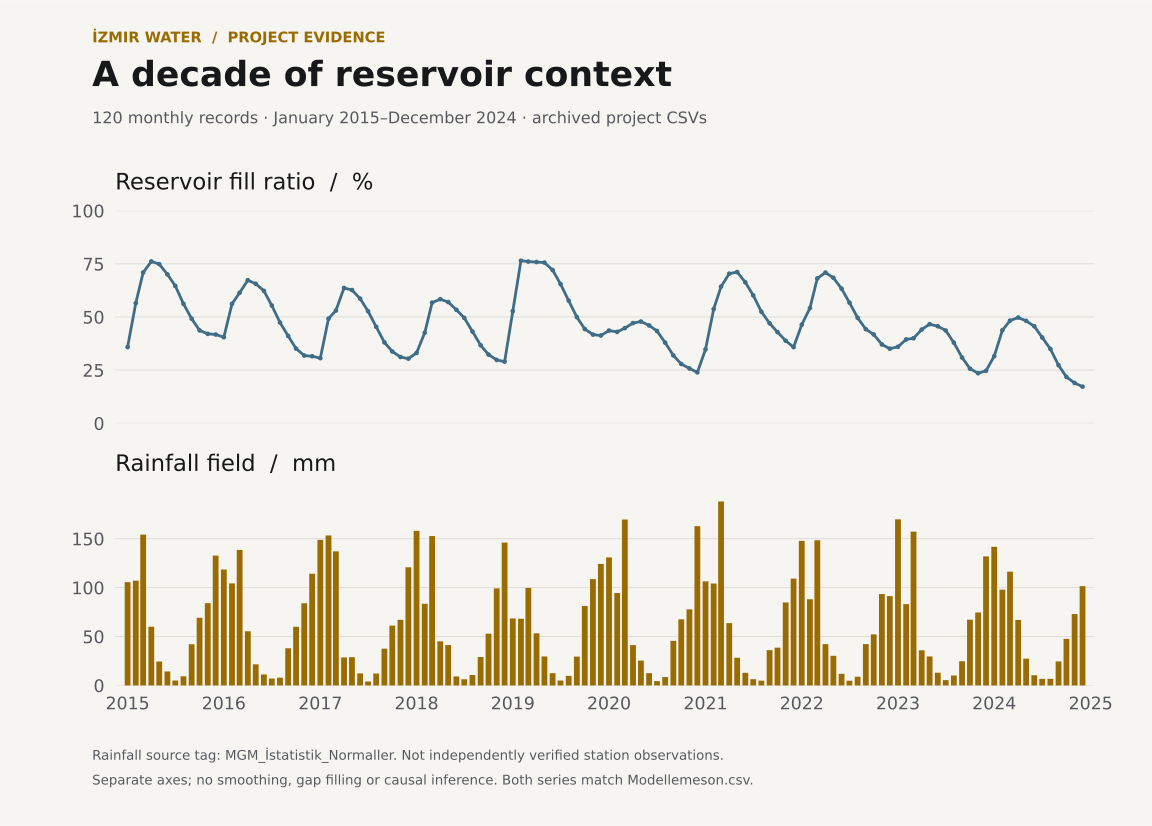
In der Wetterreihe fehlten Monate. Eine Interpolation hätte geschätzte Werte eingefügt und diesen Unterschied verdeckt; also habe ich die fehlenden Monate stattdessen aus den Stationsaufzeichnungen von Meteostat für İzmir geholt. Die Station Çiğli kommt zuerst, Adnan Menderes dient als Ersatzquelle. Wo die relative Luftfeuchte fehlte, Temperatur und Taupunkt aber vorhanden waren, wird sie über die Magnus-Formel abgeleitet, statt leer zu bleiben.
Für meinen Code gelten zwei Regeln. Er ergänzt nur fehlende Werte und überschreibt keine vorhandene Messung. Außerdem hält er die Quelle in der Ausgabedatei fest. Wer die Datei später öffnet, kann dadurch nachvollziehen, woher die ergänzten Monate stammen, ohne jemanden fragen zu müssen.
fill_izmir_real_meteostat.py
for target in [col_prcp, col_nem, col_pres, col_wspd]:
  source = target + '_ms'
    # Fill ONLY the gaps. Never overwrite a real observation.
  mask = df[target].isna() & df[source].notna()
  df.loc[mask, target] = df.loc[mask, source]

df['Kaynak_Notu'] = (
  "Real monthly values. Source: Meteostat monthly/hourly dumps. "
  "Station priority: Çiğli (17218) -> Adnan Menderes (17219). "
  "Coverage: 2015-01 .. 2024-12."
)
Nur fehlende NaN-Werte werden ergänzt. Quelle und Vorgehen werden in der Datei festgehalten.
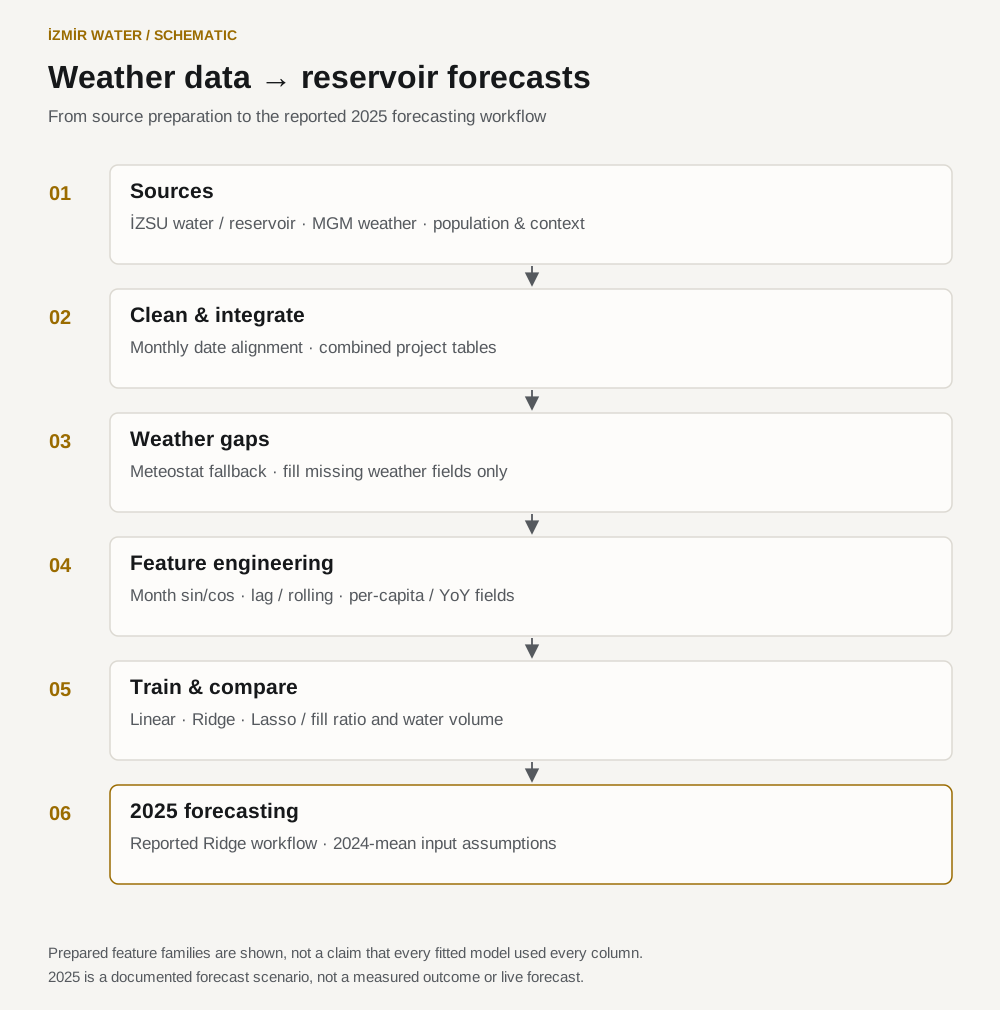
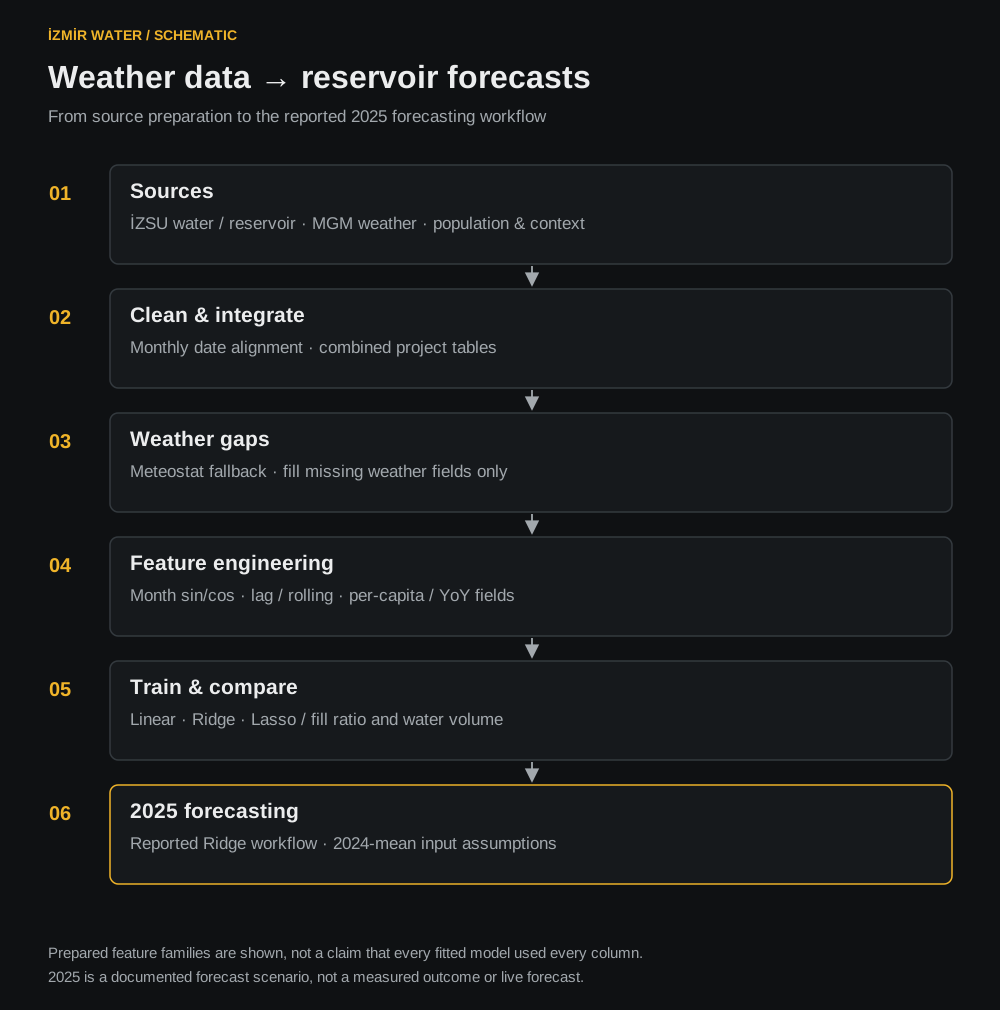
Nicht jede Spalte beruht auf Messungen. Die Tabelle enthält eine Aufteilung des Verbrauchs auf Haushalte, Industrie und Landwirtschaft sowie eine Monatssumme des Verbrauchs. Beides ist abgeleitet: die Aufteilung ist ein fester Verhältniswert, der auf jeden Monat angewendet wird, und die Monatssumme ist der Tageswert mal dreißig. Sie können für die Modellbildung hilfreich sein, sind aber keine Messwerte; deshalb führen wir sie nirgends als Ergebnis an, weder hier noch in der Präsentation.
03
Warum das einfache Modell gewann
120 Zeilen, starke Saisonalität und eine Zielgröße, die vor allem davon abhängt, wo sie letzten Monat stand.
Die Merkmale, auf die es ankam, waren die, die Zeit kodieren. Der Monat ging als Paar zyklischer Terme ein statt als schlichte Zahl, damit Dezember und Januar nebeneinanderliegen und nicht elf Monate auseinander. Der Wert des Vormonats und ein gleitender Mittelwert über drei Monate gingen als Lag-Merkmale ein. Die Jahreszeit wurde per One-Hot-Encoding abgebildet. Die Bevölkerung kam pro Kopf und als Veränderung gegenüber dem Vorjahr dazu, und wir haben ein Merkmal für die Zahl der Touristen getestet, um zu sehen, ob Sommergäste etwas erklären, was der Kalender nicht erklärt.
Wir haben lineare, Ridge- und Lasso-Regression gegen Random Forest und Gradient Boosted Trees ausgewertet. Auf diesem Datensatz schnitten die regularisierten linearen Modelle besser ab, und zwar durchgängig bei beiden Zielgrößen.
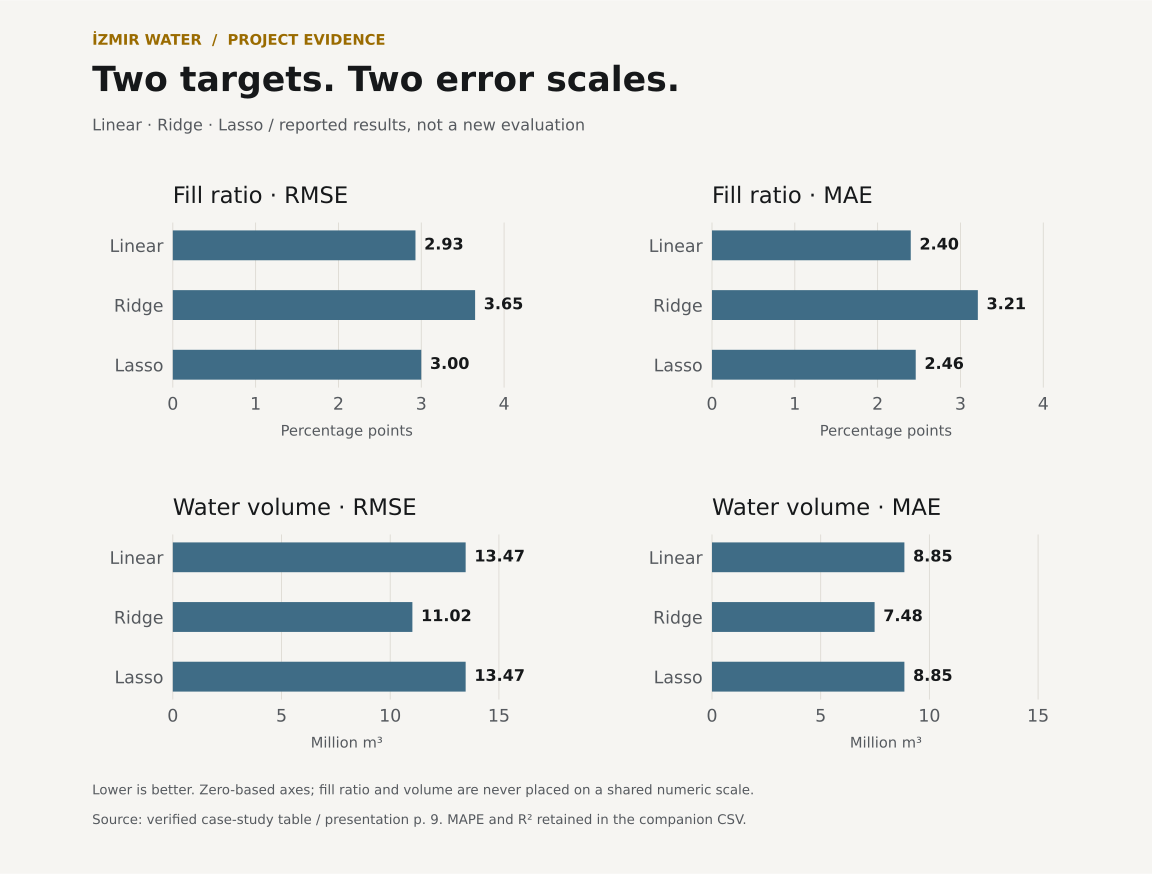
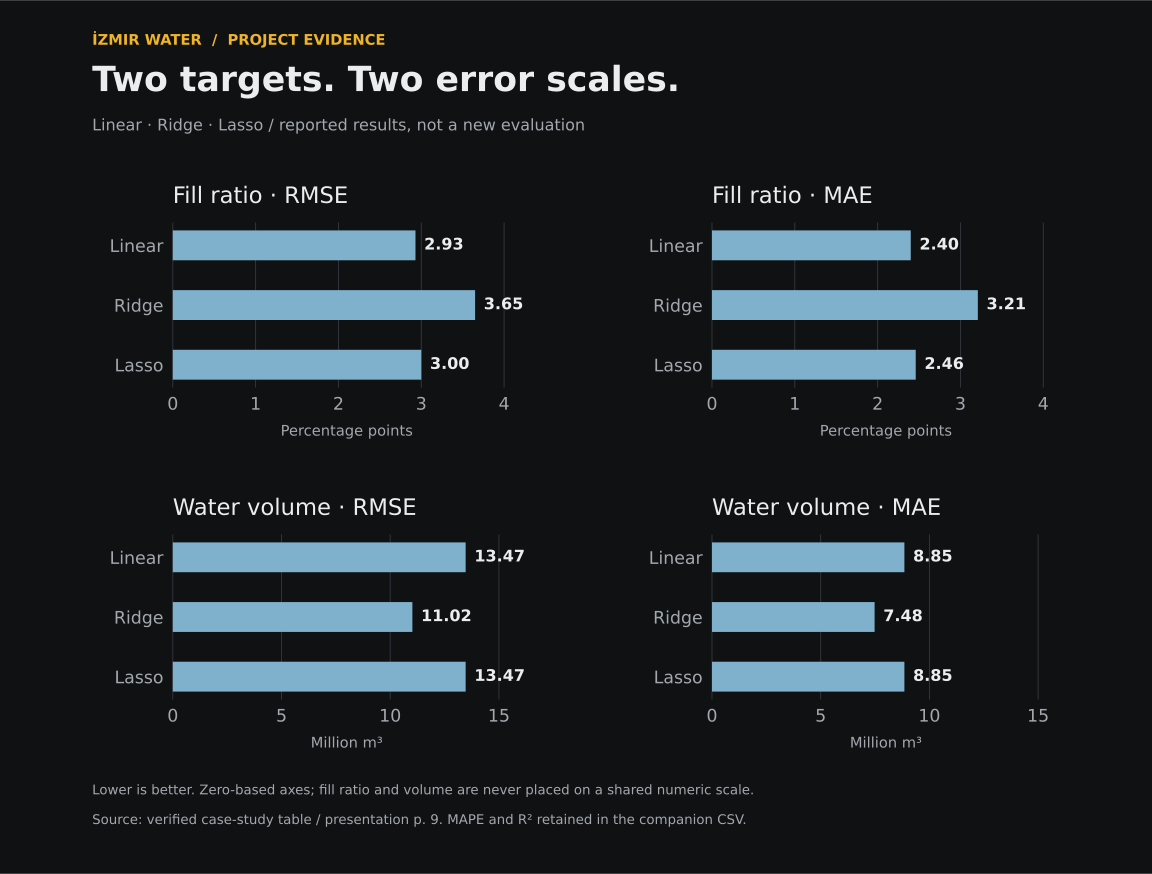
| Modell | Zielgröße | RMSE | MAE | MAPE | R² |
|---|---|---|---|---|---|
| Linear | Füllstand % | 2.93 | 2.40 | 6.74% | 0.913 |
| Lasso | Füllstand % | 3.00 | 2.46 | 6.87% | 0.909 |
| Ridge | Füllstand % | 3.65 | 3.21 | 9.14% | 0.866 |
| Ridge | Volumen m³ | 11.02M | 7.48M | 2.58% | 0.938 |
| Linear | Volumen m³ | 13.47M | 8.85M | 3.01% | 0.908 |
| Lasso | Volumen m³ | 13.47M | 8.85M | 3.01% | 0.908 |
Das liegt nicht daran, dass Bäume generell schlechter wären. 120 Monatszeilen sind sehr wenig Daten, und fast die gesamte Struktur in dieser Zielgröße ist Saisonalität plus der Stand der Reihe im Vormonat. Ein lineares Modell mit zyklischen und Lag-Termen bildet das direkt ab. Ein Ensemble muss diese Struktur erst aus den Daten lernen. Dafür ist der Datensatz hier zu klein, um sie zuverlässig zu erfassen.
Eine wichtige Einschränkung: Unsere linearen und unsere Ensemble-Läufe wurden auf unterschiedlichen Trainings- und Testaufteilungen bewertet, die Fehlerwerte lassen sich deshalb nicht unter kontrolliert gleichen Bedingungen vergleichen. Sie stützen die Entscheidung, die wir auf diesem Datensatz getroffen haben. Sie stützen keine allgemeine Aussage über die eine oder die andere Modellfamilie.
Wir haben auch festgehalten, wann wir die Modellwahl überdenken würden. Wochen- oder Tagesdaten statt Monatsdaten, ein Fehler, der zu driften beginnt, ein nicht lineares Muster, das in den Residuen liegen bleibt, oder eine wirklich neue Eingabe wie Verdunstung oder Zufluss wären jeweils ein Grund, die Ensembles noch einmal anzusehen.
04
Das nächste Jahr prognostizieren
Ein Modell muss sich auch für Prognosen nutzen lassen.
Für die Projektion auf 2025 haben wir die Ridge-Regression auf den vollen zehn Jahren trainiert und damit die folgenden Monate prognostiziert. Die Lag- und Gleitmittel-Merkmale für jeden Monat in 2025 werden aus dem Ende von 2024 berechnet. Die Eingaben, die sich nicht im Voraus wissen lassen, sind Temperatur, Niederschlag und Bevölkerung, und die werden mit den Mittelwerten von 2024 gefüllt.
Diese Mittelwerte sind eine vorläufige Annahme, keine Wetterprognose. Damit lässt sich zeigen, wie sich das Modell über ein Jahr verhält, allerdings unter den Wetterbedingungen von 2024. Für den praktischen Betrieb würde ich stattdessen meteorologische Prognosen als Eingaben verwenden. Das wäre mein nächster Schritt, zusammen mit einer automatischen Erfassung der Talsperrendaten, die wir hier noch von Hand gesammelt haben.
Was die fertige Arbeit leistet
- Führt fünf öffentliche Monatsreihen für İzmir von 2015 bis 2024 in einer Tabelle zusammen
- Dokumentiert die Quelle jeder Spalte sowie die ergänzten Monate und deren Quellen
- Füllt fehlende Wettermonate aus echten Stationsmessungen und überschreibt dabei nie einen gemessenen Wert
- Baut Merkmale für zyklischen Monat, Lag, gleitenden Mittelwert, Pro-Kopf-Werte und Vorjahresveränderung
- Vergleicht lineare, Ridge- und Lasso-Regression mit Random Forest und Gradient Boosting auf beiden Zielgrößen
- Berichtet MAE, RMSE, MAPE und R² für jedes Modell und jede Zielgröße
- Projiziert den Füllstand über 2025 aus einem Ridge-Modell, das auf dem gesamten Zeitraum trainiert wurde
Wo die Grenzen liegen
Zwei Spalten der zusammengeführten Tabelle sind abgeleitet und nicht gemessen, und nichts auf dieser Seite behandelt sie als Befund. Die Aufteilung des Verbrauchs auf Haushalte, Industrie und Landwirtschaft ist ein fester Verhältniswert, der auf jeden Monat angewendet wird, und keine gemessene Aufschlüsselung; der Monatsverbrauch ist der Tageswert mal dreißig und keine unabhängig gemessene Monatssumme. Auch der Modellvergleich hat eine wichtige Einschränkung: Für die linearen Modelle und die Ensembles wurden die Daten unterschiedlich in Training und Test aufgeteilt. Der Unterschied stützt unsere Wahl des einfachen Modells für diesen Datensatz, ist aber kein Vergleich unter kontrolliert gleichen Bedingungen. Bei 120 Zeilen gab es nicht genug Daten für einen separaten Validierungsdatensatz, und die Prognose für 2025 füllt ihre Wetter- und Bevölkerungseingaben mit den Mittelwerten von 2024. Das ist ein vernünftiger Platzhalter und keine Wettervorhersage.
Belege auf dieser Seite: Öffentlicher Datensatz · Quellcode · Erzeugte Ausgabe