F1 Race Result Prediction
Maschinelles Lernen mit einem Sport, den ich ohnehin verfolge. Aus historischen Formel-1-Ergebnissen habe ich ein Ranking-Modell entwickelt und in eine App eingebunden, die anhand der eingegebenen Startaufstellung die Reihenfolge im Ziel vorhersagt.
Was es ist Ein Ranking-Modell, das aus der Startaufstellung die Zielreihenfolge eines Formel-1-Rennens vorhersagt, verpackt in eine interaktive Anwendung.
Was ich gebaut habe Die Datenpipeline, das zeitliche Feature Engineering, das LightGBM-Ranking-Modell und die Streamlit-App, die es ausführt.
Meine Rolle
Ich wollte mir maschinelles Lernen an einem Thema beibringen, das ich ohnehin genau verfolge. Dafür habe ich alle Schritte von den historischen Rohtabellen bis zur laufenden App bearbeitet. Ich habe die Daten aufbereitet und verknüpft, den Scraper für die aktuelle Saison geschrieben und die gleitenden Formmerkmale aufgebaut. Der zeitliche Versatz hält das jeweilige Rennergebnis aus seinen eigenen Merkmalen heraus. Ich habe mich für Ranking statt Regression entschieden und die Streamlit-Oberfläche erstellt: mit Eingabe der Startaufstellung, Verarbeitung eingefügter Namenslisten und Eingabeprüfungen.
01
Ein Thema, das mir ohnehin wichtig war
Eine Methode lernt man schnell, wenn man sie auf ein Thema anwendet, über das man ohnehin gern diskutiert.
Ich verfolge die Formel 1. Autos und Fahrzeugtechnik haben überhaupt erst mein Interesse am Ingenieurwesen geweckt. Als ich maschinelles Lernen wirklich lernen wollte, statt darüber zu lesen, schien das der naheliegende Startpunkt. Ich wusste bereits, wie eine gute Antwort aussieht, und hätte sofort gemerkt, wenn mir ein Modell etwas Absurdes erzählt.
Diese Vorkenntnisse waren wichtiger als erwartet. Weil ich den Sport kenne, sind mir Fehler aufgefallen. Wenn das Modell einen Fahrer in einem Mittelfeldauto auf die Pole setzt, muss ich nichts nachmessen. Ich sehe, dass es falsch ist, und kann nach der Ursache suchen.
Damit die Aufgabe lösbar bleibt, habe ich eine konkrete Frage gewählt: welche Zielreihenfolge ist bei einer gegebenen Startaufstellung für einen bestimmten Grand Prix zu erwarten?
02
Fünfundsiebzig Jahre Ergebnisse als Trainingsdaten
Die Geschichte der Formel 1 ist gut dokumentiert. Für das Modell müssen die Daten aber erst aufbereitet werden.
Der historische Datensatz besteht aus verknüpften Tabellen zu Rennen, Strecken, Fahrern, Teams, Ergebnissen, Qualifying und Status. Er reicht bis 1950 zurück. Von dort zu einer Trainingstabelle zu kommen ist der größte Teil der Arbeit.
Ergebnisse und Rennen werden über die Renn-ID verknüpft. Aus dem Qualifying bleibt je Fahrer die beste Position aus Q1 bis Q3. Anschließend werden alle Einträge chronologisch sortiert, damit Berechnungen über vergangene Rennen die richtige zeitliche Reihenfolge einhalten.
Die aktuelle Saison steht nicht im historischen Datensatz, also habe ich einen Scraper dafür geschrieben. Er liest die Klassifikationstabellen von den Wikipedia-Seiten der bisher gefahrenen Grands Prix 2025, normalisiert Fahrernamen und unterschiedliche Teamnamen zu einheitlichen Slugs. Die Ausgabe hat dasselbe Format wie die historischen Dateien.
Das Training beginnt 2021, nicht 1950. Reglement, Fahrzeugkonzepte und Punktesysteme des Sports haben sich so stark verändert, dass ein Ergebnis aus einer früheren Ära einen anderen Sport beschreibt. Das Fenster wird aus den Daten abgeleitet statt fest einprogrammiert. Das Modell trainiert bis zur letzten vollständigen Saison und sagt die darauffolgende voraus, deshalb meldet die App “Training 2021 bis 2024, Vorhersage 2025”, weil genau das in den Dateien steht.
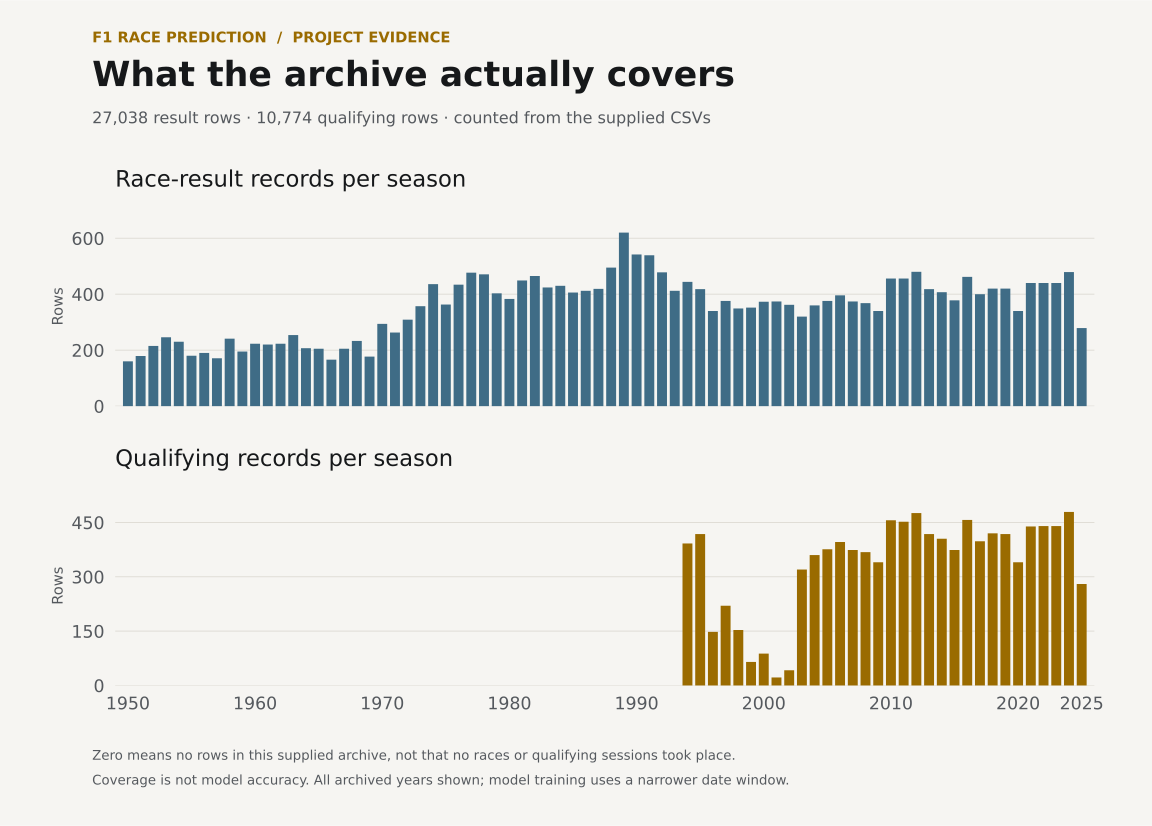
- Historische Ergebnisse 27,038 Rennergebnisse, 1950 bis 2025
- Qualifying 10,774 Sitzungen, reduziert auf eine beste Position je Fahrer und Rennen
- Trainingsfenster 2021 bis zur letzten vollständigen Saison
- Aktuelle Saison Aus den Klassifikationstabellen der einzelnen Wikipedia-Rennseiten gesammelt
- Ziel Learning to Rank: LightGBM lambdarank, ndcg, nach Rennen gruppiert
03
Nur Informationen, die vor dem Rennstart bekannt waren
Die schwierige Aufgabe ist nicht die Wahl des Algorithmus, sondern zu verhindern, dass das Rennergebnis bereits in den Eingabemerkmalen steckt.
Die jüngste Form eines Fahrers ist das nützlichste einzelne Signal, das zur Verfügung steht, und zugleich der einfachste Weg, ein Modell zu bauen, das hervorragend aussieht und wertlos ist. Enthält der gleitende Mittelwert der Zielposition eines Fahrers dieses Rennen, dann steckt das Label im Merkmal, und das Modell lernt, die Antwort daran abzulesen.
Die vier Formmerkmale sind so gebaut, dass das nicht passieren kann. Jedes ist ein gleitender Mittelwert der letzten drei Zielpositionen, und jedes wird zuerst um ein Rennen verschoben, sodass der Wert an einem Rennen strikt aus den Rennen davor berechnet wird:
app.py · build_training_table()
df["drv_last3_mean"] = (
  df.groupby("driverId")["positionOrder"]
      # shift(1) first: this race cannot see its own result
    .transform(lambda s: s.shift(1).rolling(3, min_periods=1).mean())
)
Der Shift kommt vor dem gleitenden Fenster, damit ein Rennen nie zu seinem eigenen Merkmal beiträgt.
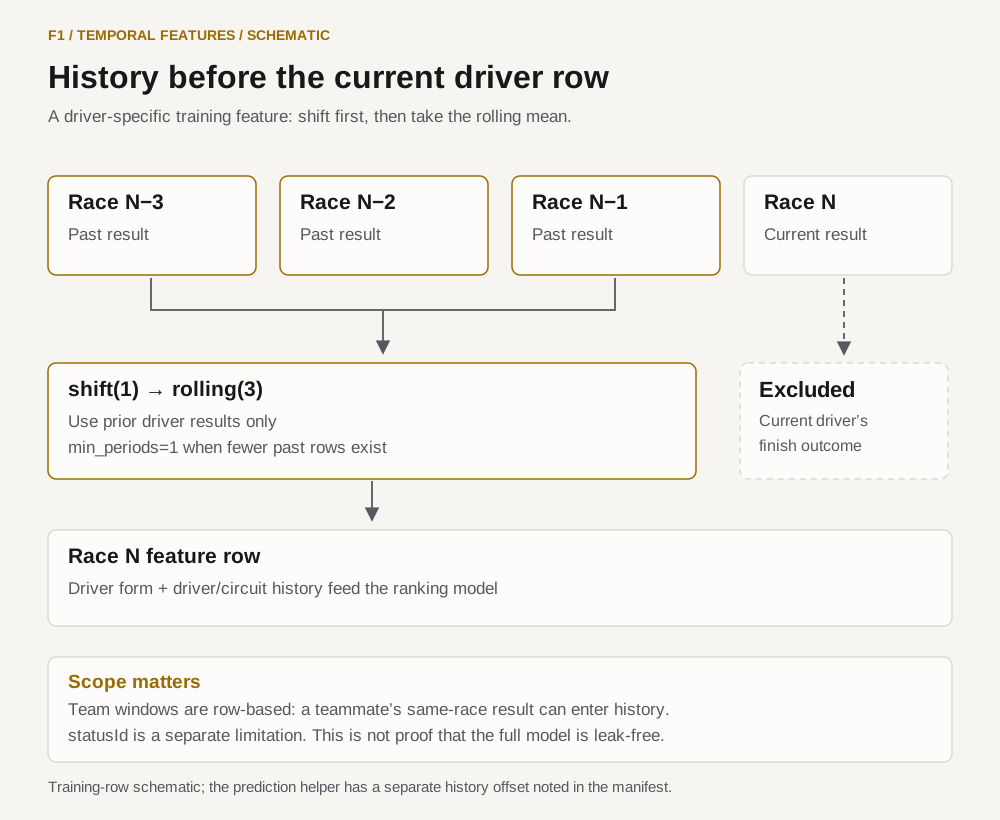
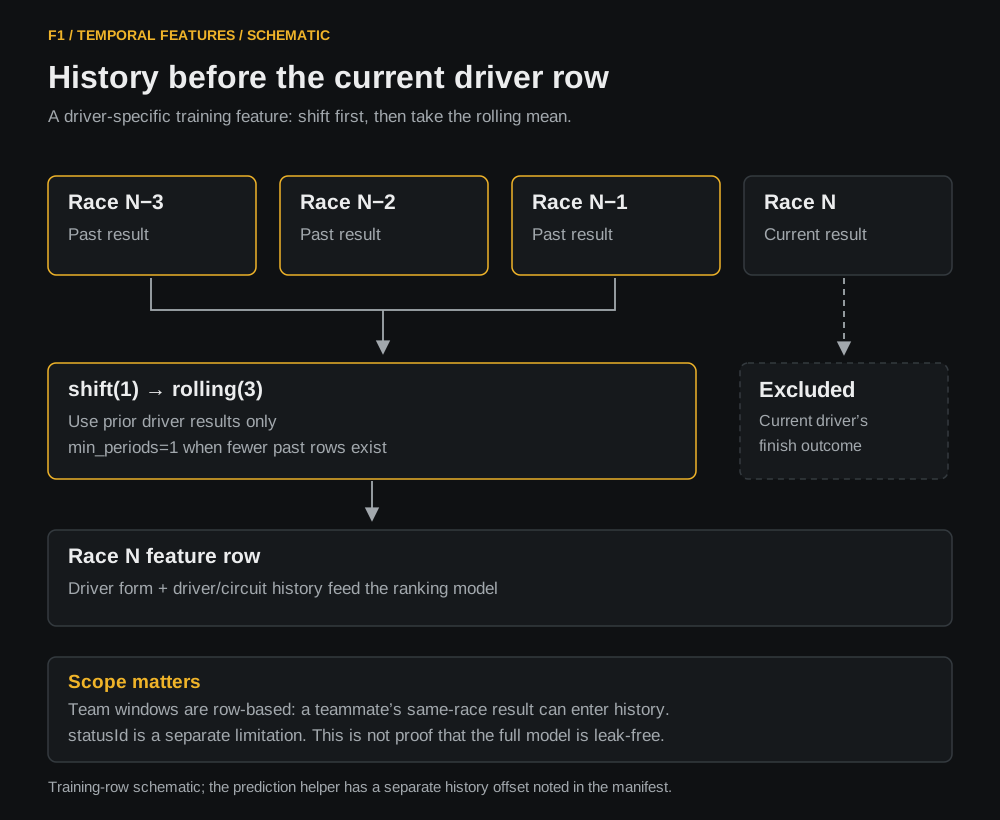
Mit demselben Verfahren entstehen vier Formmerkmale: für den Fahrer insgesamt und auf der gewählten Strecke sowie für das Team insgesamt und auf dieser Strecke. In Monaco und Monza sind unterschiedliche Fahrzeugeigenschaften gefragt. Deshalb sagt die allgemeine Form eines Teams etwas anderes aus als seine Form auf einem bestimmten Kurs.
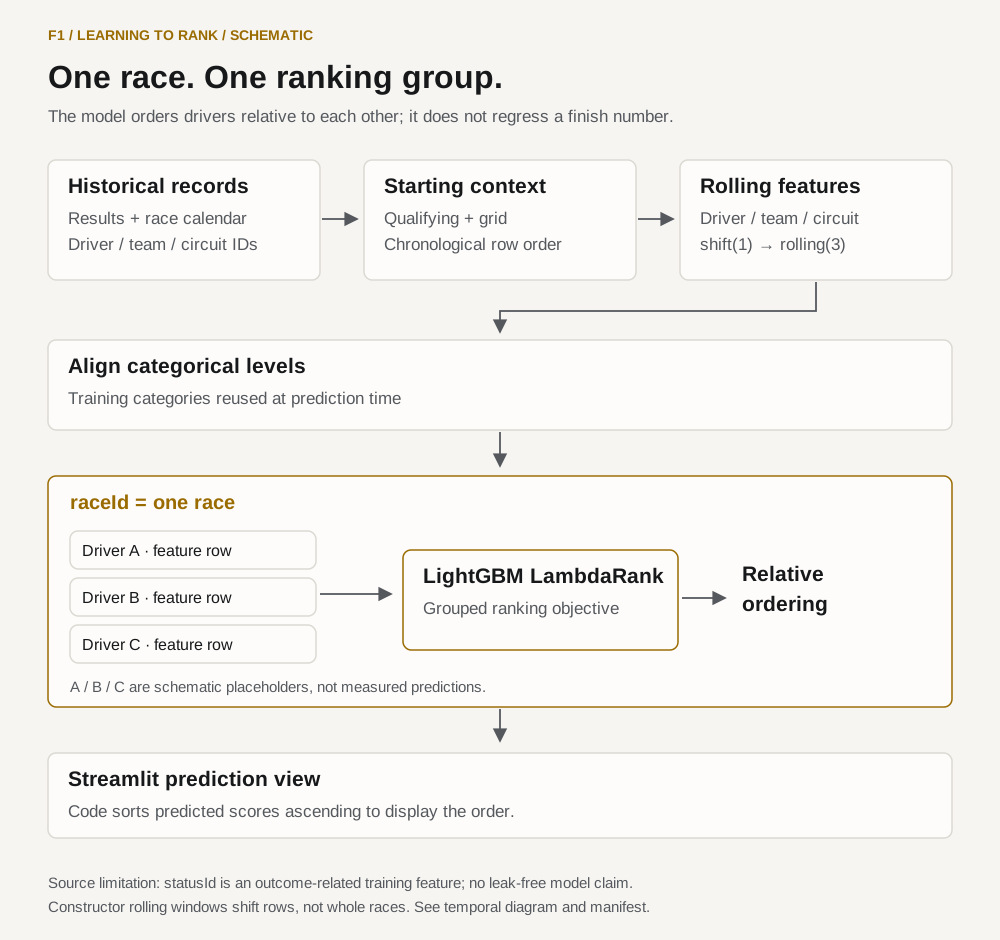
Die zweite Entscheidung betrifft das Lernziel. Wer die Zielposition als
einzelne Zahl vorhersagt, behandelt den Unterschied zwischen Platz eins und
zwei genauso wie den zwischen Platz fünfzehn und sechzehn. Außerdem
berücksichtigt dieser Ansatz nicht, dass nur ein Auto gewinnen kann. Also wird das Modell stattdessen auf Ranking
trainiert: das lambdarank-Ziel von LightGBM, mit nach Rennen gruppierten
Zeilen, sodass jedes Rennen ein Ranking-Problem ist und das Modell an der
Reihenfolge gemessen wird, die es innerhalb dieses Rennens erzeugt, statt am
absoluten Fehler je Fahrer.
Bei meiner damaligen Auswertung habe ich rund 82% Genauigkeit festgehalten. Das ist ein Ergebnis aus diesem Projekt, kein später unter dokumentierten Bedingungen reproduzierter Benchmark. In meinen Unterlagen fehlen sowohl die Definition der Metrik als auch das genaue Validierungsverfahren. Wie aussagekräftig eine Zahl ist, hängt davon ab, wie gut ihre Entstehung dokumentiert wurde.
04
Vom trainierten Modell zur nutzbaren Anwendung
Im Notebook arbeitet das Modell mit vorbereiteten Eingaben. In der Anwendung lässt es sich mit neuen Startaufstellungen ausprobieren.
Zum Schluss habe ich das trainierte Modell in eine Anwendung eingebunden, in die man eine Startaufstellung eingeben kann. Die App lädt die CSV-Dateien, baut die Trainingstabelle, trainiert den Ranker einmal und legt ihn im Cache ab, und bietet dann einen Grand Prix, eine Fahrerzahl und zwanzig Positionen zum Ausfüllen an.
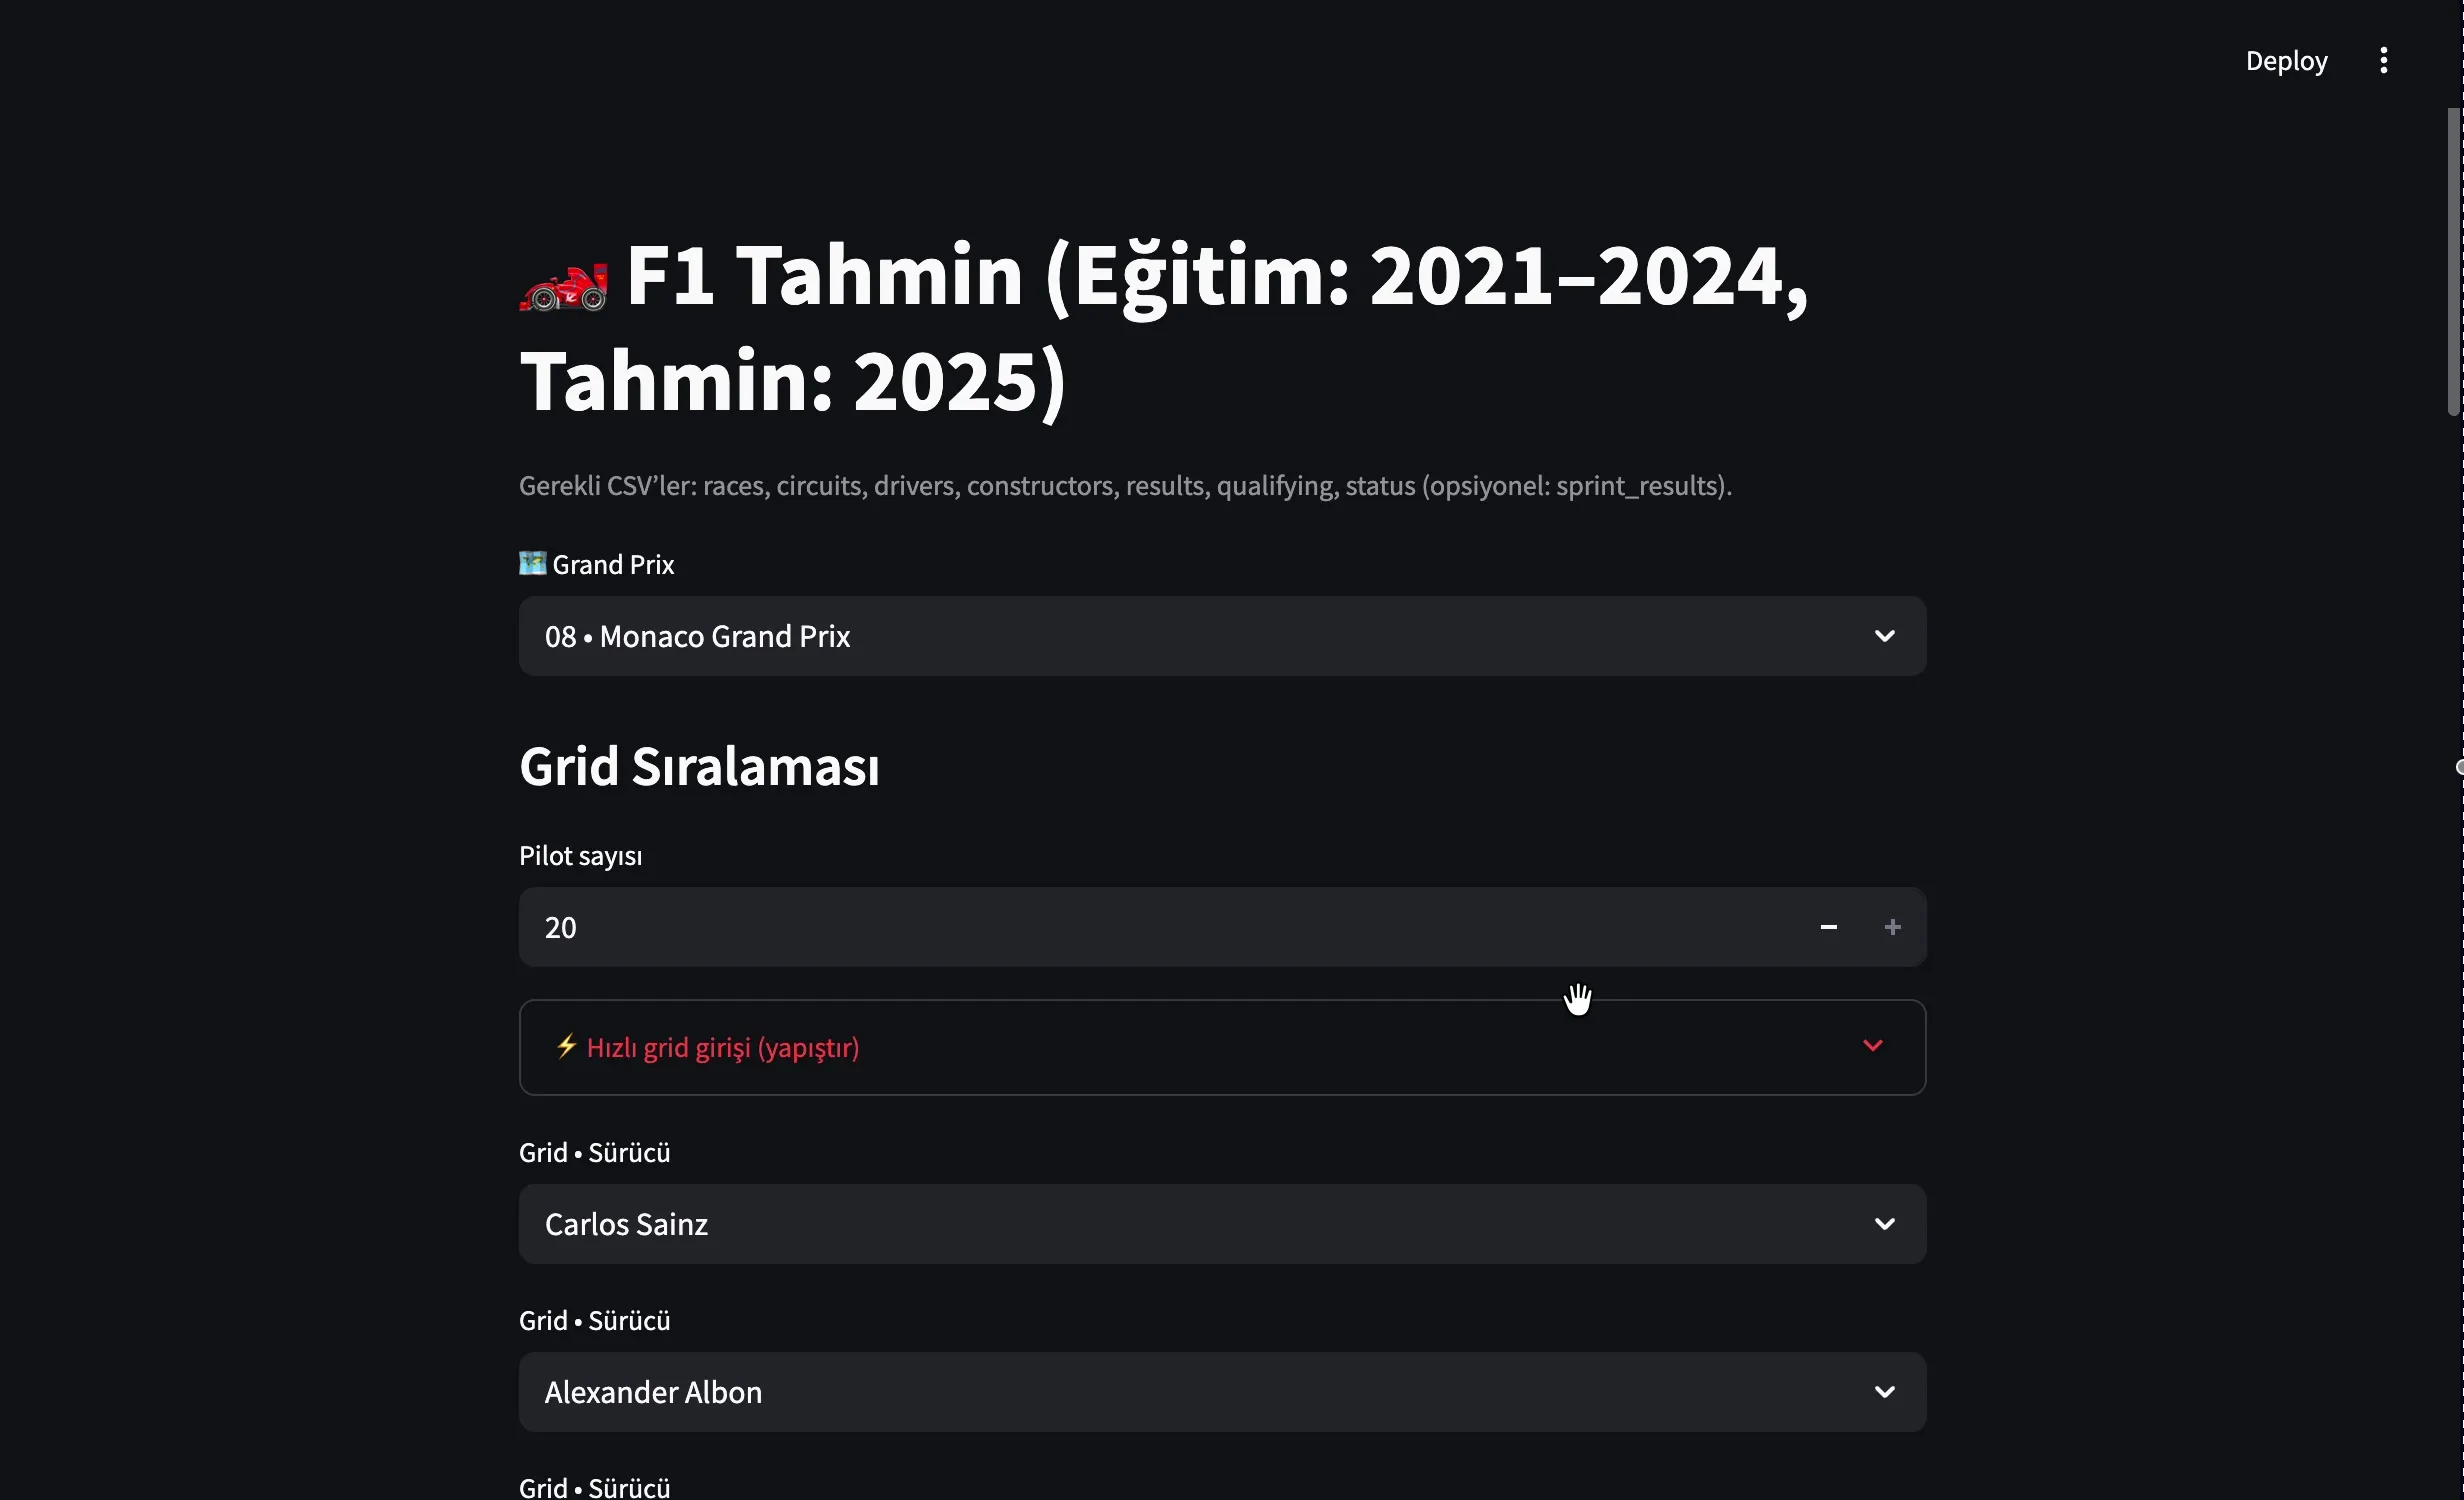
Zwanzig Dropdowns von Hand zu füllen wird sofort mühsam, deshalb gibt es ein Textfeld zum Einfügen einer Namensliste. Ein Name pro Zeile, ganz oben die Pole-Position. Es normalisiert türkische Zeichen, damit auch auf einer türkischen Tastatur getippte Namen passen, und fällt auf den Nachnamen zurück, wenn der vollständige Name nicht erkannt wird. Es verweigert die Vorhersage, wenn derselbe Fahrer zweimal auftaucht, also genau die Art Prüfung, die man erst einbaut, nachdem einem der Fehler selbst passiert ist.
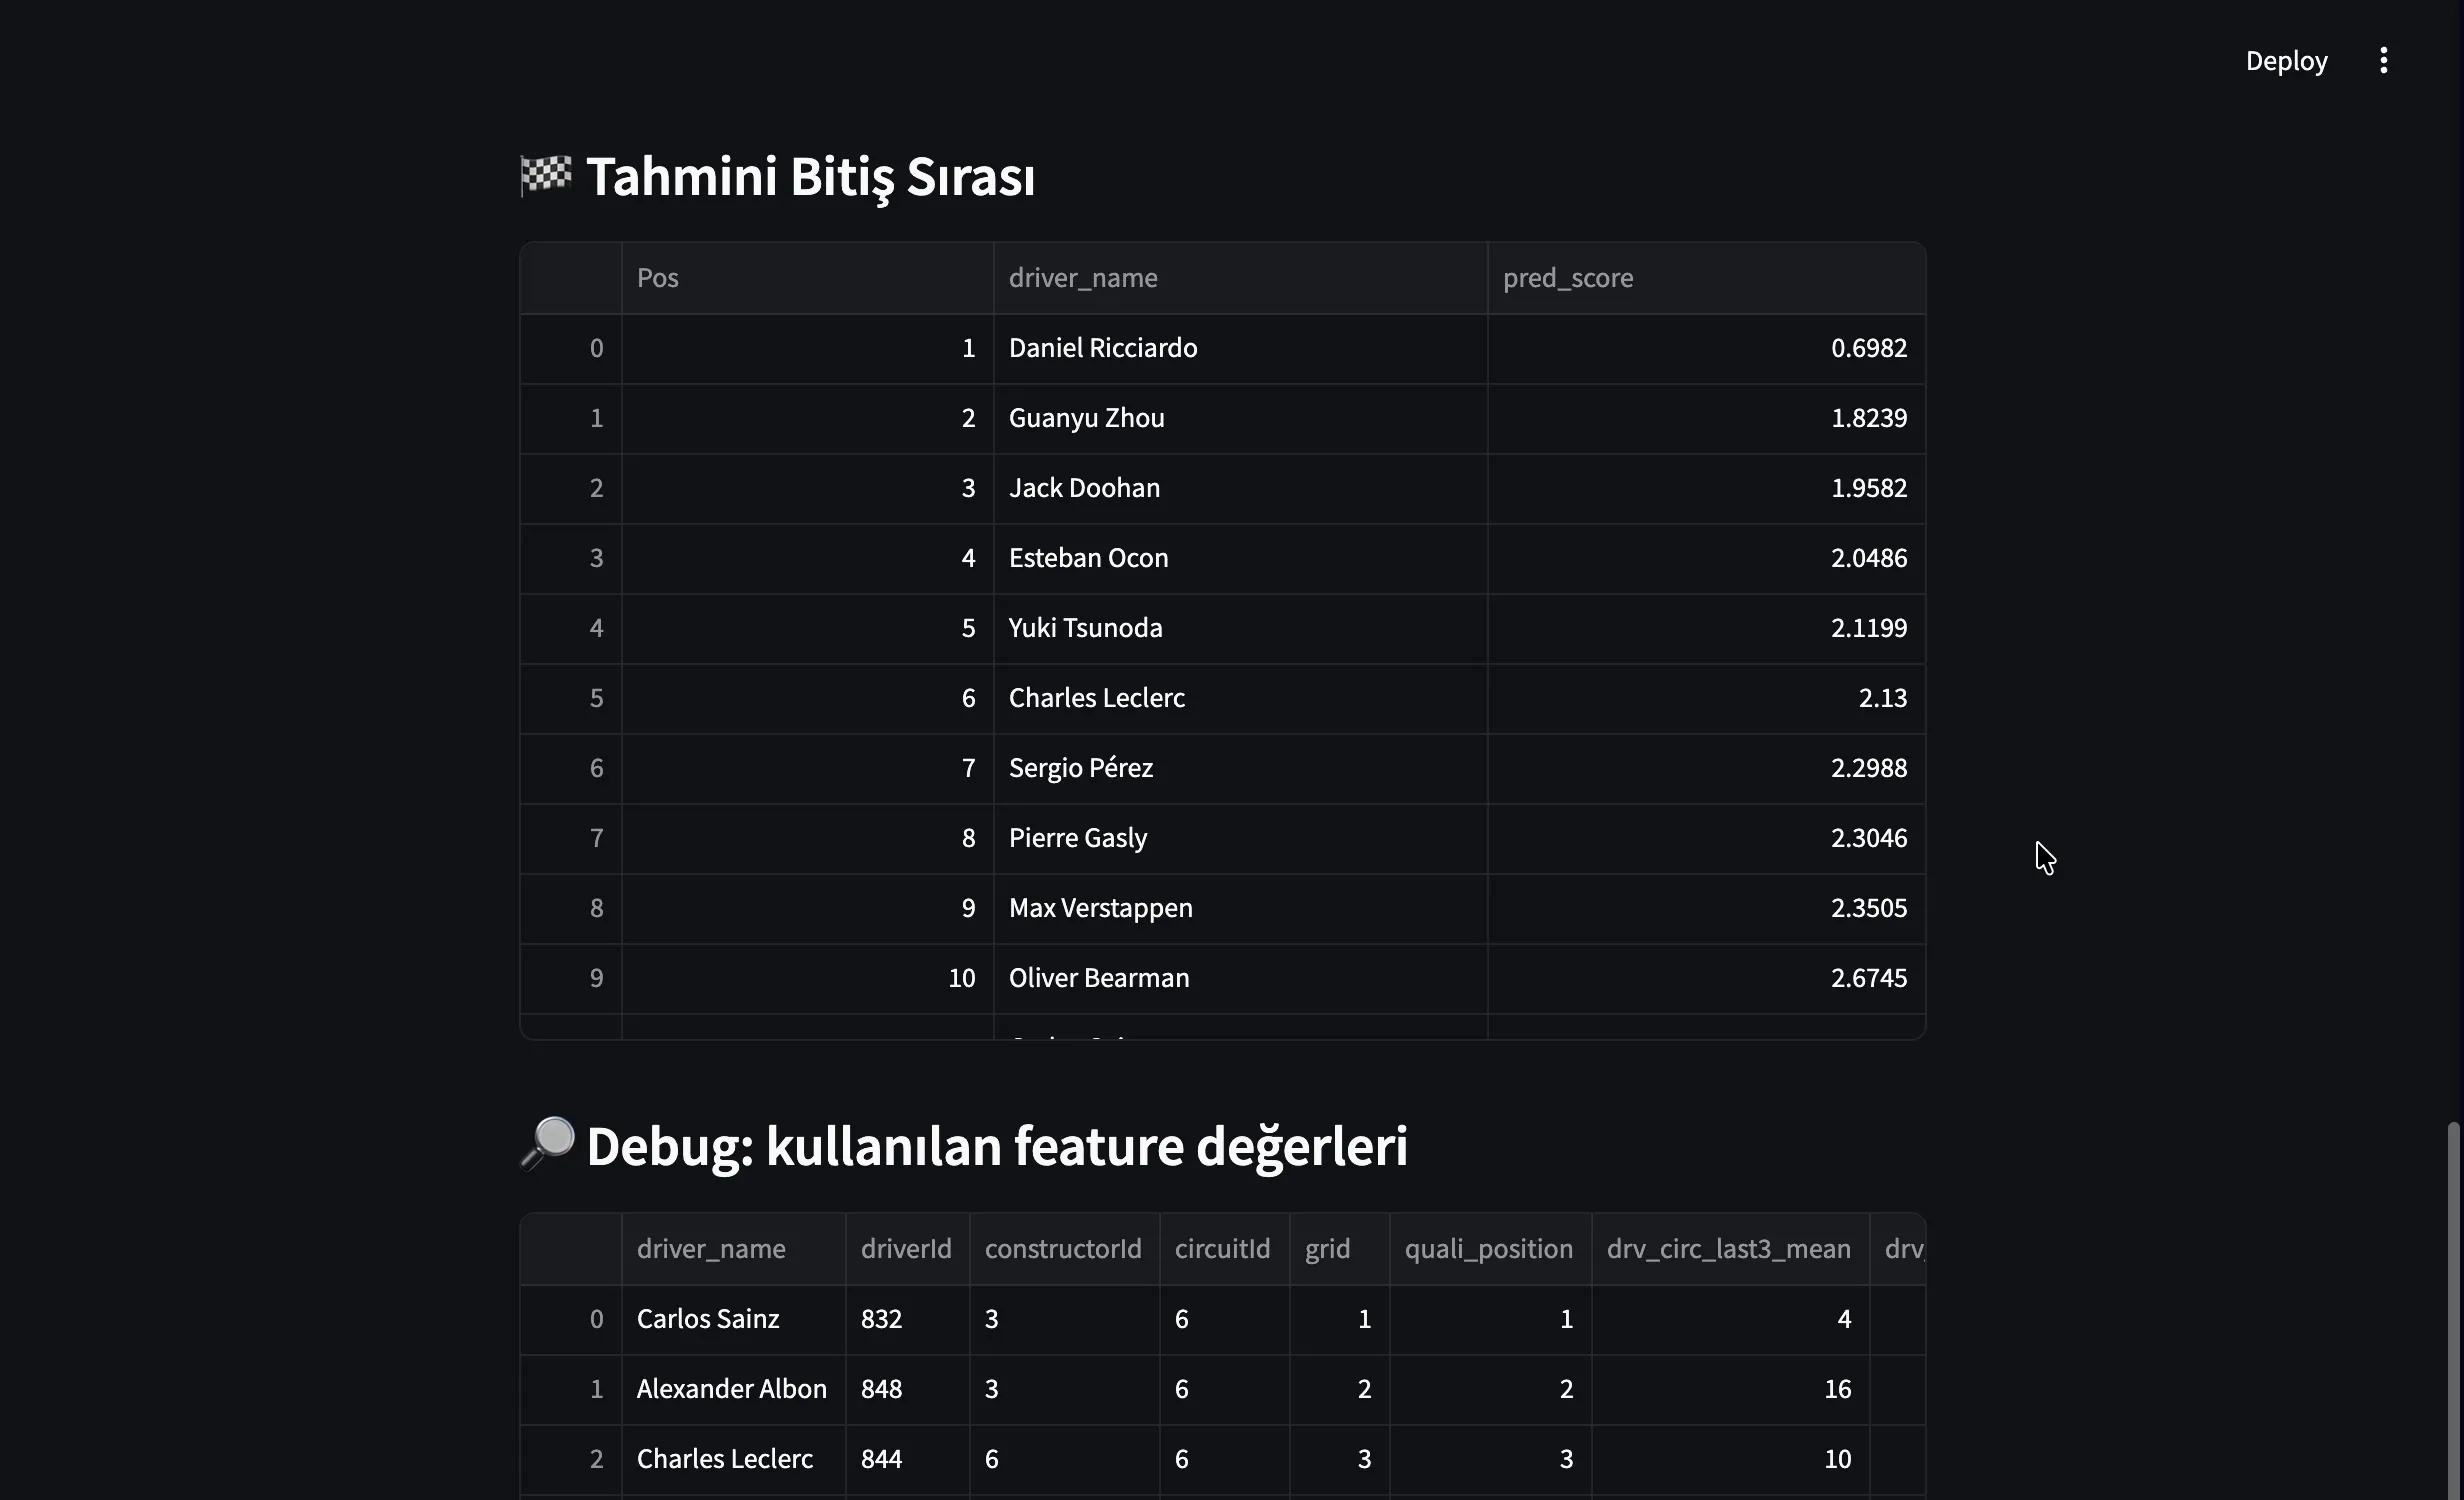
Für jeden Fahrer in der Startaufstellung ermittelt die App sein aktuelles Team, über diese Saison, wenn er darin gefahren ist, und sonst über seine jüngste Saison. Die App berechnet die vier Formmerkmale für die gewählte Strecke neu, gleicht die Kategorien mit denen aus dem Training ab und lässt das Modell Scores berechnen. Daraus ergibt sich durch Sortieren die vorhergesagte Reihenfolge.
Was die fertige Anwendung leistet
- Lädt und verbindet die historischen Tabellen zu Rennen, Qualifying, Fahrern, Teams und Strecken
- Leitet Trainings- und Vorhersagesaison aus den Daten ab und nicht aus einer Konstante
- Baut vier gleitende Formmerkmale, jedes so verschoben, dass ein Rennen sein eigenes Ergebnis nicht sehen kann
- Trainiert ein LightGBM-lambdarank-Modell mit Zeilen, die Rennen für Rennen gruppiert sind
- Nimmt eine Startaufstellung per Dropdown oder als eingefügte Liste entgegen, mit Prüfung auf doppelte Fahrer
- Ordnet jedem Fahrer sein aktuelles Team zu und berechnet die Form für die gewählte Strecke neu
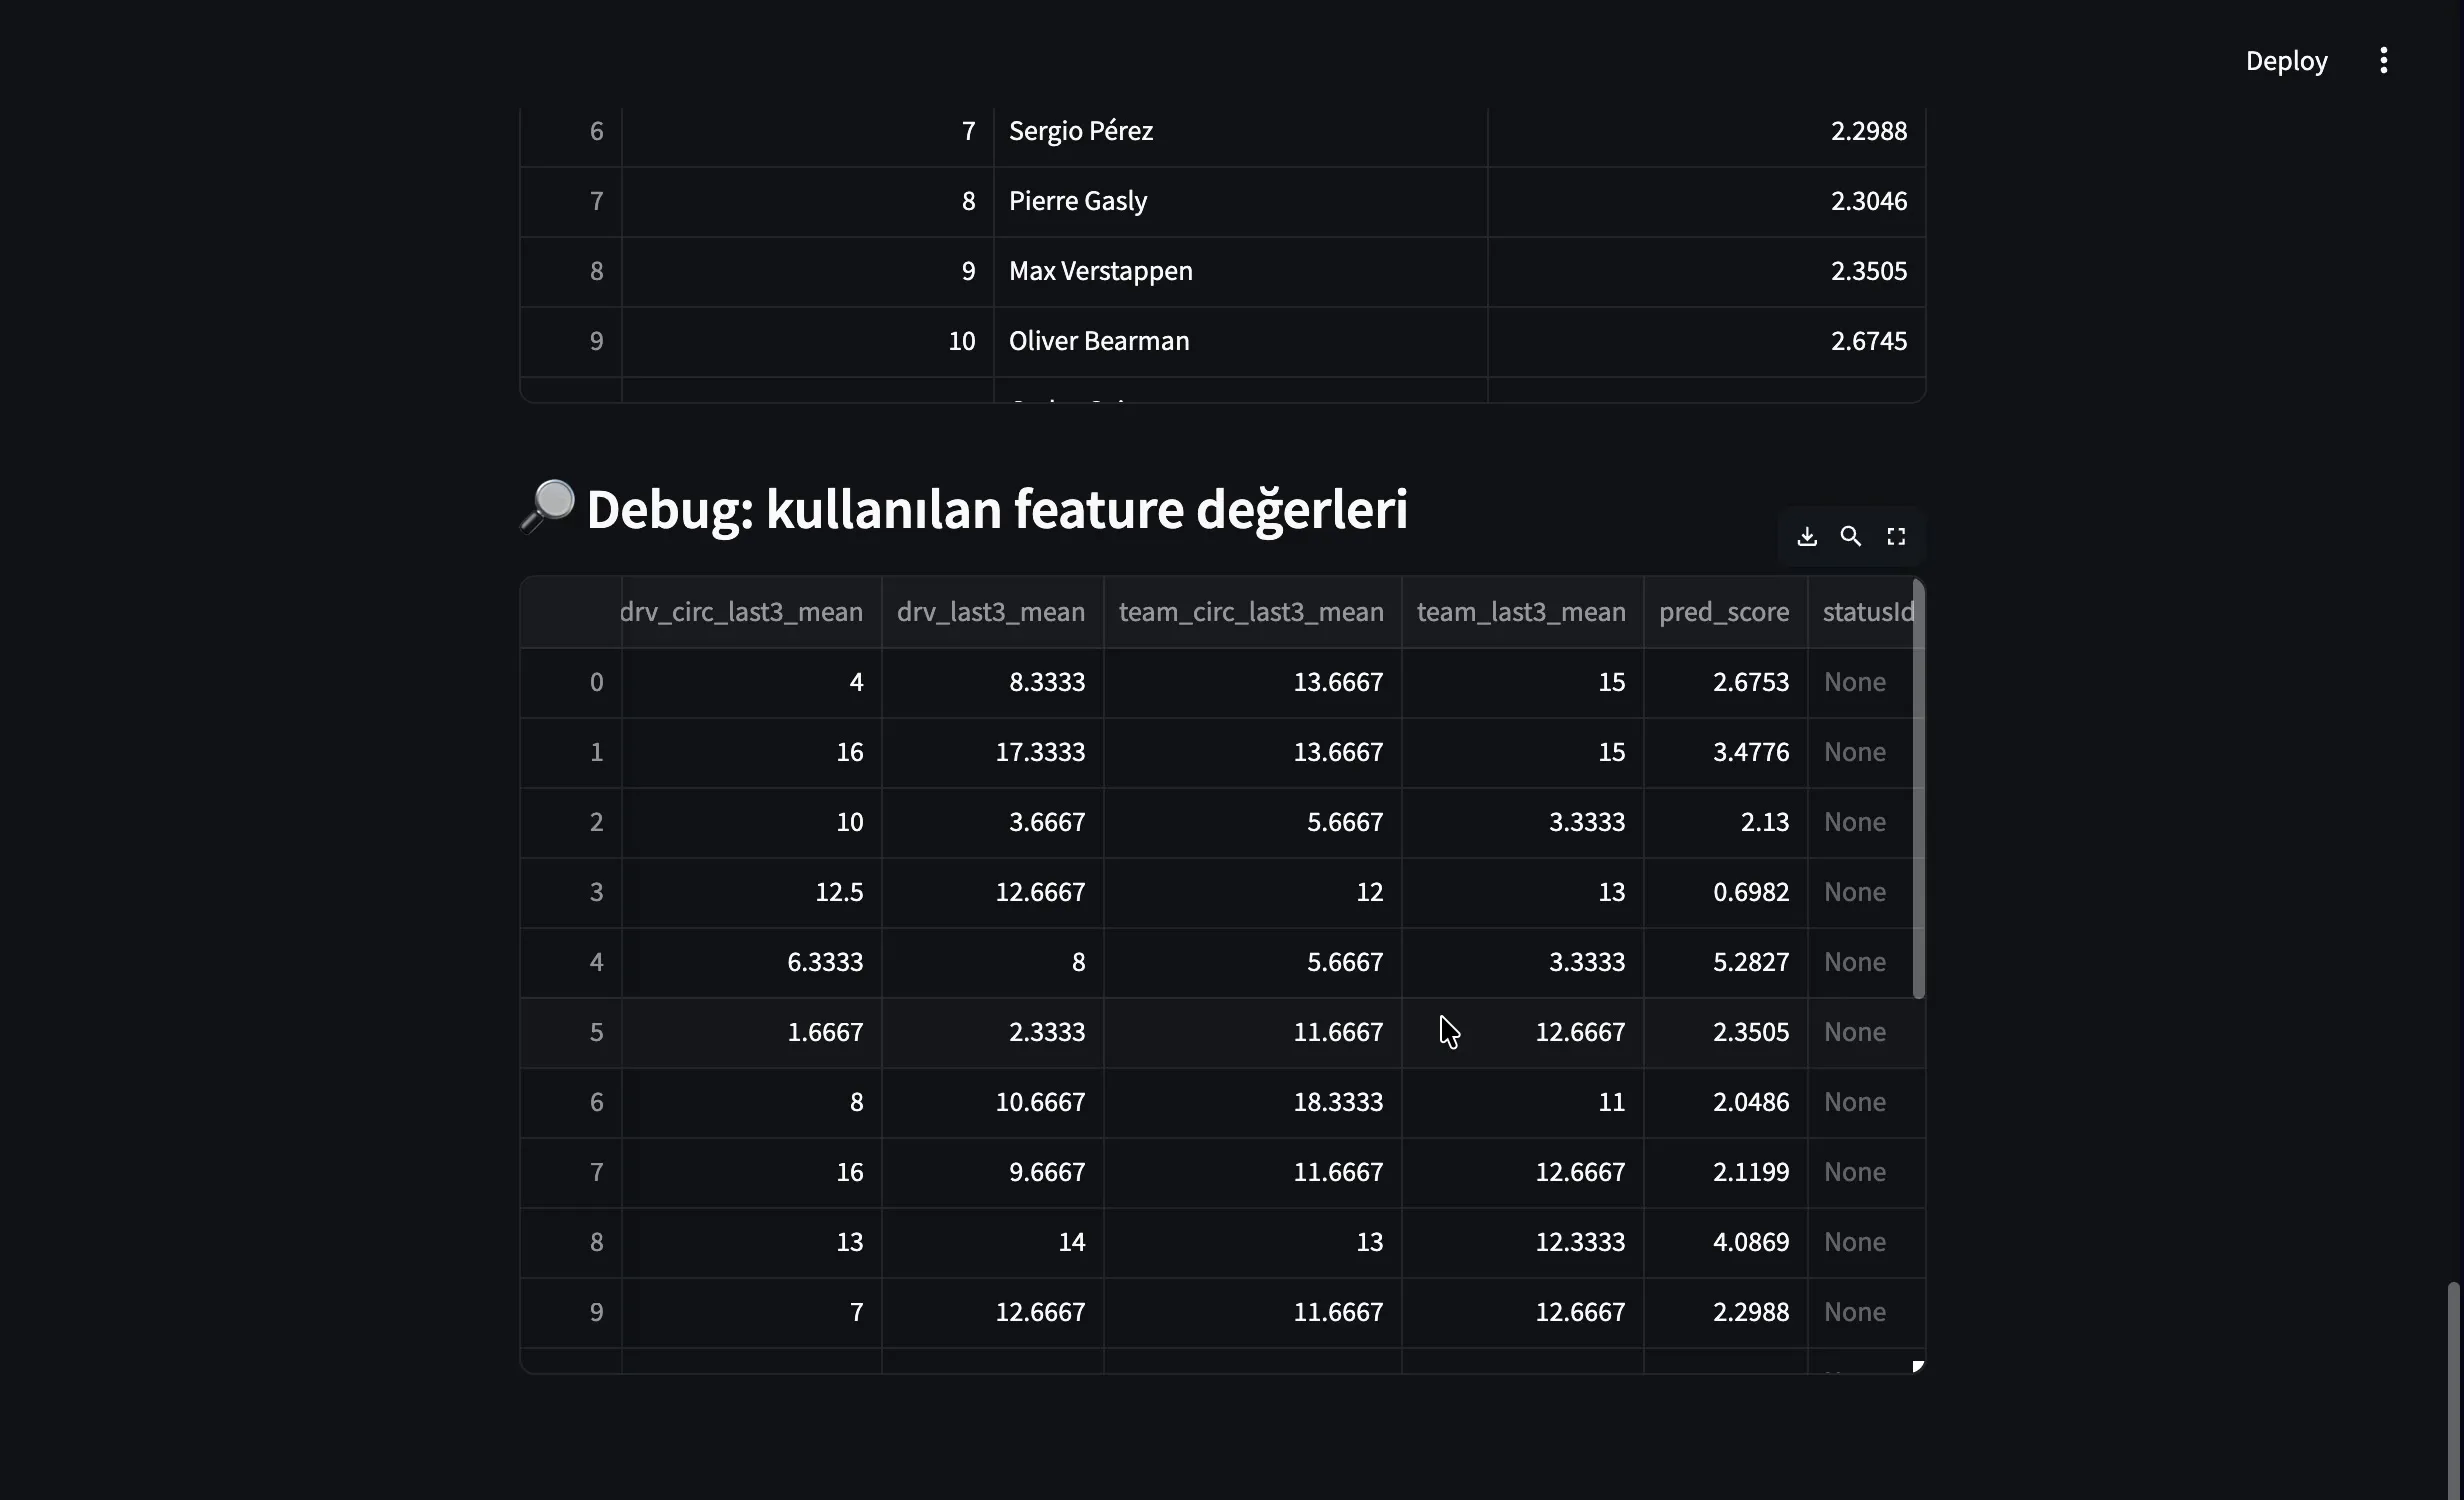
- Gibt eine vorhergesagte Zielreihenfolge zurück und kann jeden Merkmalswert dahinter anzeigen
Wo die Grenzen liegen
Das Modell hat eine wichtige Einschränkung. Die Merkmalsliste enthält weiterhin den Status-Code des Rennens, der festhält, ob ein Auto ins Ziel kam, ausfiel oder einen Unfall hatte. Das ist ein Ergebnis des Rennens und nichts, was sich davor wissen ließe, und zum Vorhersagezeitpunkt bleibt es schlicht leer. Die gleitenden Formmerkmale sind sauber abgesichert und die Eingaben aus Qualifying und Startaufstellung sind vor dem Rennen bekannt, aber ich würde die Pipeline als Ganzes nicht als frei von Data Leakage bezeichnen, solange diese Spalte nicht entfernt und das Modell neu trainiert ist. Darüber hinaus weiß das Modell nichts über Wetter, Reifenstrategie, Zuverlässigkeit, Upgrades oder Fahrerwechsel mitten in der Saison. Eine Startaufstellung und eine Historie von Zielpositionen ist alles, was es sieht.
Belege auf dieser Seite: Quellcode · Erzeugte Ausgabe