VR Prosodic Speech Analysis System
VR egzersizinde kişinin konuşma biçimini ölçüp kendi sakin ve aceleci konuşma kayıtlarına göre değerlendiren, tamamlanmış bir sistem.
Nedir Bir VR egzersizi sırasında sesteki uyarılmayı ölçen ve kişiye göre normalize edilmiş bir puanı gerçek zamanlı gösteren bir sistem.
Ne yaptım Python analiz motoru ve VR katmanının çağırdığı FastAPI servisi.
Benim rolüm
Python analiz motorunu ben tasarlayıp yazdım. Ses kaydı, Faster-Whisper ile konuşmayı metne dönüştürme ve kelime zamanlaması, Praat ve librosa ile prozodik özellikleri çıkarma bu çalışmanın parçalarıydı. İki referans kaydına dayalı kişisel kalibrasyonu, puanlamayı, kalite kontrollerini ve oturumların kaydedilmesini de hazırladım. VR katmanının çağırdığı FastAPI servisini de ben yazdım. Depodaki her commit bana ait. Sistem, başlık Quest Link üzerinden bağlıyken tek bir Windows PC üzerinde baştan sona çalışıyor.
01
Birinin nasıl konuştuğunu ölçmek
Bir VR egzersizinde, kişinin konuşma biçimi görev puanının yakalamadığı bir bilgi taşıyor.
Biri VR içinde simüle edilmiş bir prosedürü uygularken sistem, adımları tamamlayıp tamamlamadığını zaten biliyor. Ama o sırada nasıl konuştuğunu bilmiyor. Sesin perdesi, şiddeti, konuşma hızı ve duraklamalar bu konuda bilgi veriyor. Egzersiz devam ederken bu bilgileri bir puana dönüştürmek istedim.
Sabit bir eşik işe yaramıyor. 180 Hz veya 70 dB üzerindeki her değeri yüksek uyarılma kabul edersem, kişinin o anki durumundan çok sesinin doğal özelliklerini ölçmüş oluyorum. Doğal olarak gür konuşan biri sakinken bile o çizgiyi geçiyor. Kısık konuşan biri gerçek baskı altında bile hiç geçmiyor. Herkese aynı akustik eşiği uygulamak, farklı seslerin aynı şekilde değerlendirilebileceğini varsayıyor. Ben ise bir kişinin kendi sesindeki değişimi bulmak istiyordum.
- Donanım Tek bir Windows PC, Quest Link üzerinden Meta Quest 3, Oculus sanal mikrofonundan 16 kHz mono ses
- Etkileşim Tek bir kumanda tuşu: kaydetmek için basılı tut, analiz için bırak
- Sınır Ses analizini C# ile tekrar yazmadım. Analizin tek uygulaması Python tarafında
- Gecikme Analiz, egzersiz hâlâ sürerken sonuç döndürüyor
- İlke Kötü bir puan döndürmektense hiçbir şey döndürme
02
Tek eşik yerine iki referans kaydı
Her konuşmacı için ayrı bir ölçek oluşturuluyor. Ölçeğin iki ucu da o kişinin kendi sesinden ölçülüyor.
Egzersizden önce kullanıcı iki kısa cümle kaydediyor. Normal tonda söylediği cümle sakin referansını, yani baseline değerini oluşturuyor. Aceleci bir tonla söylediği cümle ise upperline referansı oluyor. Her özellik için kişinin değerlendirme aralığı, bu iki kayıttaki değerlerin farkıyla belirleniyor.
Sonraki kayıtlar bu iki referansa göre değerlendiriliyor: baseline sıfır, upperline bir kabul ediliyor. Yüksek sesli ve kısık sesli iki kişi, kendi aralıkları içinde aynı oranda aceleci konuşmaya yaklaştıysa aynı puanı alıyor.
Diyagram: kişisel kalibrasyon
Konuşmacı A
daha gür, daha tiz
Baseline 112 Hz 0
Upperline 196 Hz 100
Konuşmacı B
daha kısık, daha pes
Baseline 78 Hz 0
Upperline 121 Hz 100
İşaretli fark
acele ederken yavaşlıyor
Baseline 5.4 syll/s 0
Upperline 4.1 syll/s 100
Özellikle önemsediğim ayrıntı, iki referans arasındaki farkın işaretini korumak. Çoğu kişi acele ederken daha hızlı konuşuyor; bu durumda artikülasyon hızının upperline değeri baseline değerinden yüksek oluyor. Bazılarıysa yavaşlayıp daha dikkatli konuşuyor. Formül bu farkı hata saymıyor. Kişinin gösterdiği değişim yönünü koruyor; fark negatif olsa da puanı aynı şekilde hesaplıyor.
app_speech_integrated.py · compare_with_two_anchors()
raw_progress = (
  current_number - baseline_number
) / gap

# Baseline'ın ters yönündeki değişim panik puanı üretmez.
score_progress = max(raw_progress, 0.0)

# Upperline'ı aşmak mümkündür. 1.25 sınırı, tek özelliğin
# bütün skoru aşırı şişirmesini engeller.
score_progress = min(score_progress, 1.25)

weighted_progress += score_progress * weight
used_weight += weight
Kişinin iki referansı arasındaki değişimin hesabı. Negatif farklar için de aynı formül kullanılıyor. Ters yöndeki değişim sıfır sayılıyor; tek bir özelliğin puanı aşırı yükseltmemesi için üst sınır uygulanıyor.
Puan altı özellikten hesaplanıyor. Her özelliğin bir ağırlığı ve minimum fark eşiği var. Bu eşik, iki referans kaydı arasındaki farkın gürültüden kaynaklanmadığını kabul etmek için gereken en küçük değer.
| Özellik | Ağırlık | Minimum fark | Kaynak |
|---|---|---|---|
| F0 medyanı | 0.25 | 5 Hz | Praat perde |
| Ortalama şiddet | 0.20 | 2 dB | Praat şiddet |
| Artikülasyon hızı | 0.20 | 0.30 syll/s | Whisper kelime zamanlaması |
| Maksimum şiddet | 0.15 | 3 dB | Praat şiddet |
| Perde aralığı (p90−p10) | 0.10 | 5 Hz | Praat perde |
| Duraklama oranı | 0.10 | 0.03 | Whisper kelime zamanlaması |
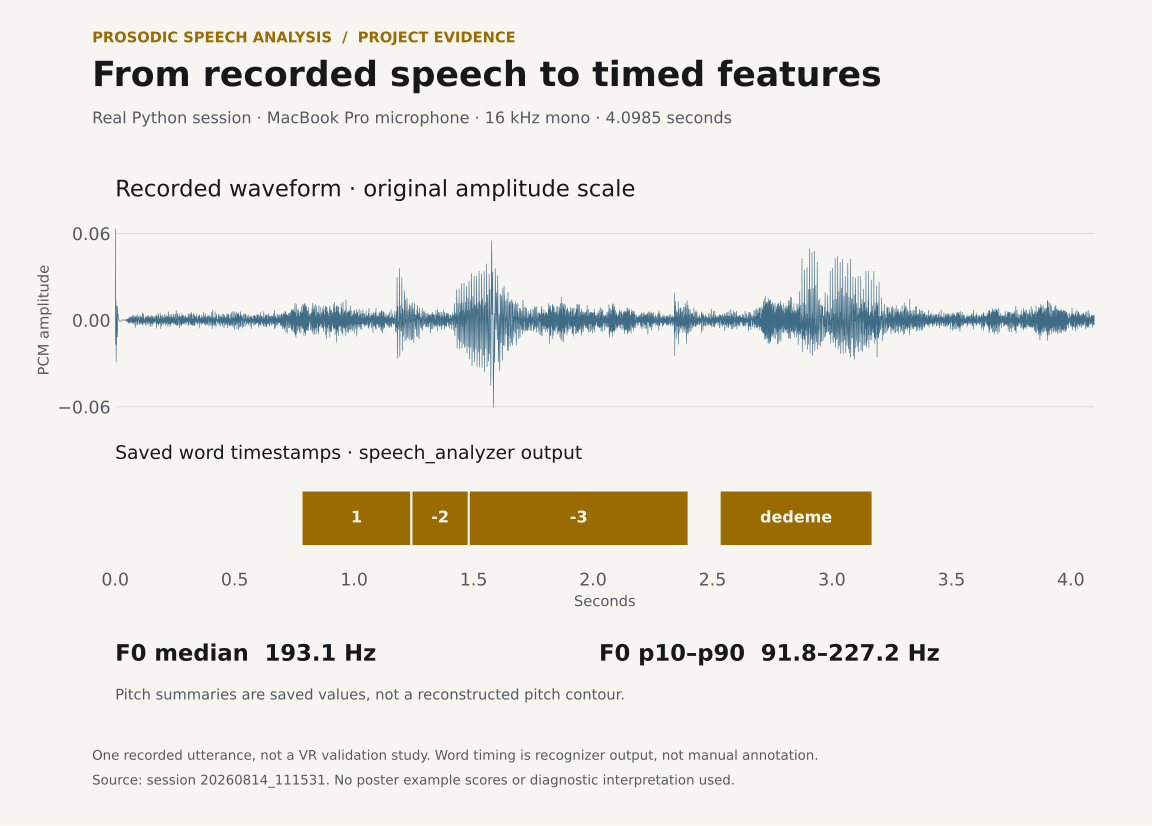
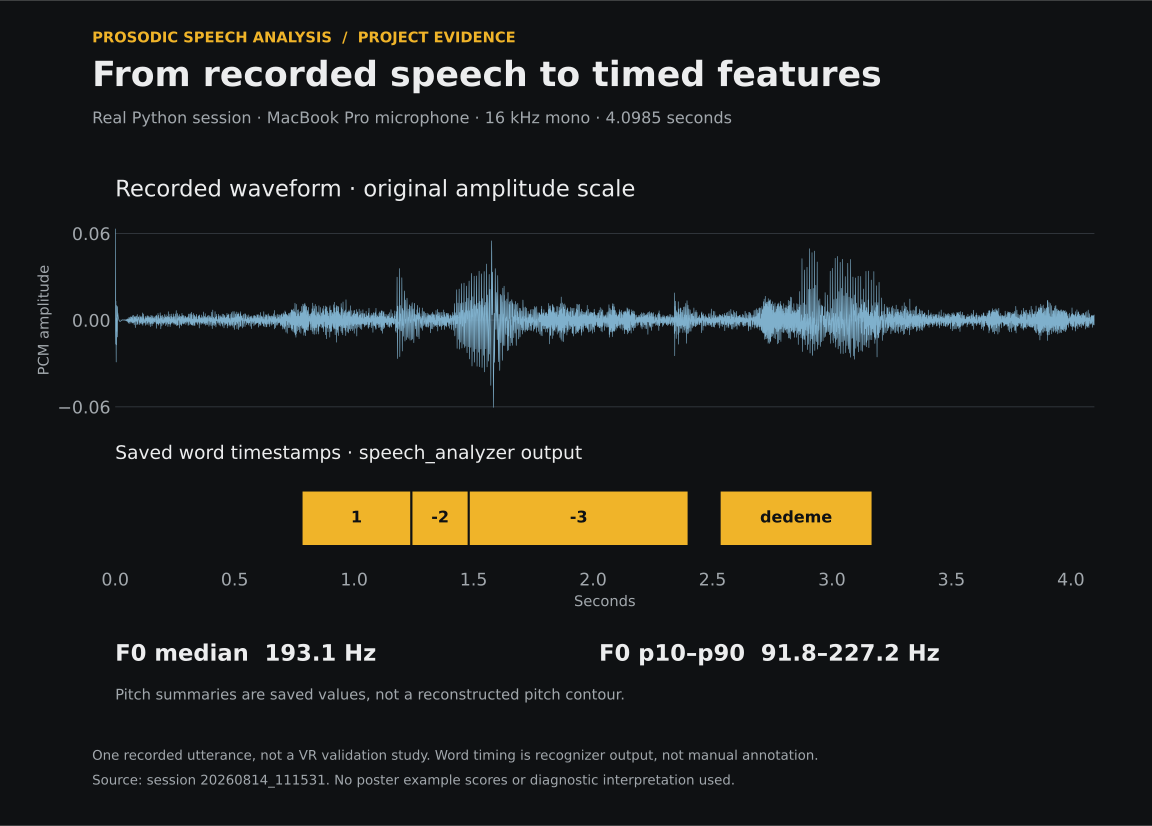
Zamanlama, enerji tabanlı ses etkinliği tespiti yerine Faster-Whisper’ın kelime düzeyindeki zaman damgalarından geliyor. Enerji tabanlı VAD, bir duraklamayı sessiz bir odadan ayırt edemiyor ve gürültülü bir başlık mikrofonu durumu daha da kötüleştiriyor. Metne dönüştürme sırasında bulunan kelime sınırları, konuşmanın nerede durakladığını belirlemek için çok daha iyi bir temel sağlıyor. Heceler, Türkçe ünlüler sayılarak yaklaşık olarak bulunuyor. Bu yaklaşık yöntem kodda açıkça belirtiliyor; gerçek bir hece ayırma algoritması değil ama bir konuşmacıyı kendisiyle karşılaştırmak için yeterli.
Sistem bilerek iki katman halinde kurulmuş, aralarında bir HTTP köprüsü var.
Diyagram: sistem mimarisi
VR katmanı
Python analiz motoru
- 01 16 kHz mono kayıt
- 02 Metne dönüştür · Faster-Whisper
- 03 Prozodik özellikleri çıkar
- 04 Kalite kontrolleri
- 05 Kişisel kalibrasyon
- 06 Puan 0-100
Başlık bağlı olmadan da çalışıyor
Bu ayrımı değerli kılan şey, bütün ölçümün Python’da kalması. Praat, librosa ve Faster-Whisper’ın C# tarafında karşılığı yok. Bunların bir kısmını VR projesine taşımak, ölçümün ikinci bir uygulamasını yaratırdı ve ikisini birbiriyle uyumlu tutmak zorunda kalırdım.
03
Yanıltıcı puanları önlemek
Buradaki mühendislik çalışmasının büyük kısmı, hangi durumlarda sonuç verilmemesi gerektiğini belirlemekti.
Ekranda bir sayı gördüğümüzde ona güvenmeye eğilimliyiz. Bu yüzden hangi durumlarda puan verileceğini dikkatle belirlemek gerekiyor. Bu sistemde en çok önemsediğim çalışma, aşağıdaki kalite kontrolleri.
Diyagram: puanlama ve kalite kontrolleri
- 01
Kayıt kullanılabilir mi?
Tepe değeri ≥ 0.99 ise kırpılma, 0.02 altındaysa fazla kısık, ötümlü çerçeveler %20 altında
Uyar ve kaydı tekrar iste
- 02
Kalibrasyon cümlesi söylendi mi?
Konuşmadan çıkarılan metin, istenen cümleyle karşılaştırılıyor
Referans kaydını tekrarla
- 03
Bu özellikte yeterli fark var mı?
Baseline ile upperline arasındaki fark, bu özellik için belirlenen minimum eşiği karşılamalı
Özelliği puanlamadan çıkar
- 04
Puan için yeterli bilgi kaldı mı?
En az iki özellik kalmalı, toplam ağırlık en az 0.40 olmalı
Kalibrasyonu reddet
Tüm kontroller geçilirse
- Her özellikte iki referans arasındaki değişim, kişinin gösterdiği yön korunarak hesaplanıyor
- Ters yöndeki değişim puana katkı yapmıyor
- Tek bir özelliğin katkısı 1.25 ile sınırlanıyor; toplam puanı aşırı yükseltemiyor
- Ağırlıklar uygulanıyor, sonuç 0-100 aralığında tutuluyor
En önemli kontrol, her özellik için ayrı yapılıyor. Baseline ve upperline kayıtları bir özellikte yeterince farklı değilse, o özellik kişinin durumundaki değişim hakkında bilgi vermiyor. Örneğin iki kayıtta da aynı perdeden konuşmuş olabilir. Bunu hesaba katmak yalnızca gürültü ekler. Bu yüzden özellik çıkarılıyor, kalanların ağırlıkları yeniden ayarlanarak puan hesaplanıyor.
Çok fazla özellik elenirse puan hesaplamak için yeterli bilgi kalmıyor. Kullanılabilir özellik sayısı ikinin veya toplam ağırlık 0.40’ın altına düşerse kalibrasyon kabul edilmiyor. Kullanıcının referans cümlelerini yeniden kaydetmesi gerekiyor.
Kayıt kalitesi bunların hepsinden önce kontrol ediliyor. Tepe değerinin 0.99 veya üzerinde olması nedeniyle kırpılma oluşması, 0.02 altında kalması veya ötümlü ses içeren çerçevelerin %20’nin altında olması uyarı veriyor. Daha ince bir kontrol daha var. Ses etkinliği tespiti, pencerenin %98 veya fazlasının aktif konuşma olduğunu bildiriyorsa, bu genellikle gürültülü bir odanın kesintisiz konuşma olarak duyulması demek ve buradan türeyen zamanlama öznitelikleri güvenilir değil.
baseline_manager.py · evaluate_recording_quality()
if speech_window > 0:
  active_ratio = active_duration / speech_window

  if active_ratio >= 0.98:
      warnings.append(
          "Kayıdın neredeyse tamamı aktif konuşma olarak algılandı. "
          "Gürültü nedeniyle VAD/sessizlik tespiti güvenilir olmayabilir."
      )
Bu kontrol, konuşmacıyı değil ortam gürültüsünü değerlendirmek için var.
Sevdiğim bir kontrol daha var. Kalibrasyon cümlesinin kendisi doğrulanıyor: kişinin söylediğinin deşifresi, söylemesi istenen cümleyle karşılaştırılıyor. Yanındaki kişiyle konuşurken kaydedilmiş bir baseline, sonraki bütün puanların ölçüldüğü referans haline sessizce gelmemeli.
04
Tamamlanmış sistem
Kaydı başlatan tuştan puanın gösterilmesine kadar tüm süreç tek bir bilgisayarda çalışıyor.
Sistem, baştan sona
- Quest mikrofonundaki sesi Quest Link üzerinden kaydediyor
- Kumanda tuşu, FastAPI servisinin
/startve/stopuç noktalarını çağırıyor - Faster-Whisper’dan konuşma metnini ve kelimelerin zamanlarını alıyor
- Her kayıttan altı prozodik özellik çıkarıyor: F0 medyanı ve aralığı, ortalama ve maksimum şiddet, artikülasyon hızı, duraklama oranı
- Baseline ve upperline kayıtlarıyla kişisel kalibrasyon profili oluşturuyor ve kullanmadan önce geçerliliğini kontrol ediyor
- VR paneline kişiye göre normalize edilmiş 0-100 arası bir puan döndürüyor
- Sonradan incelenebilmesi için her konuşma kaydını JSON olarak saklıyor, oturum CSV’si ve raporu oluşturuyor
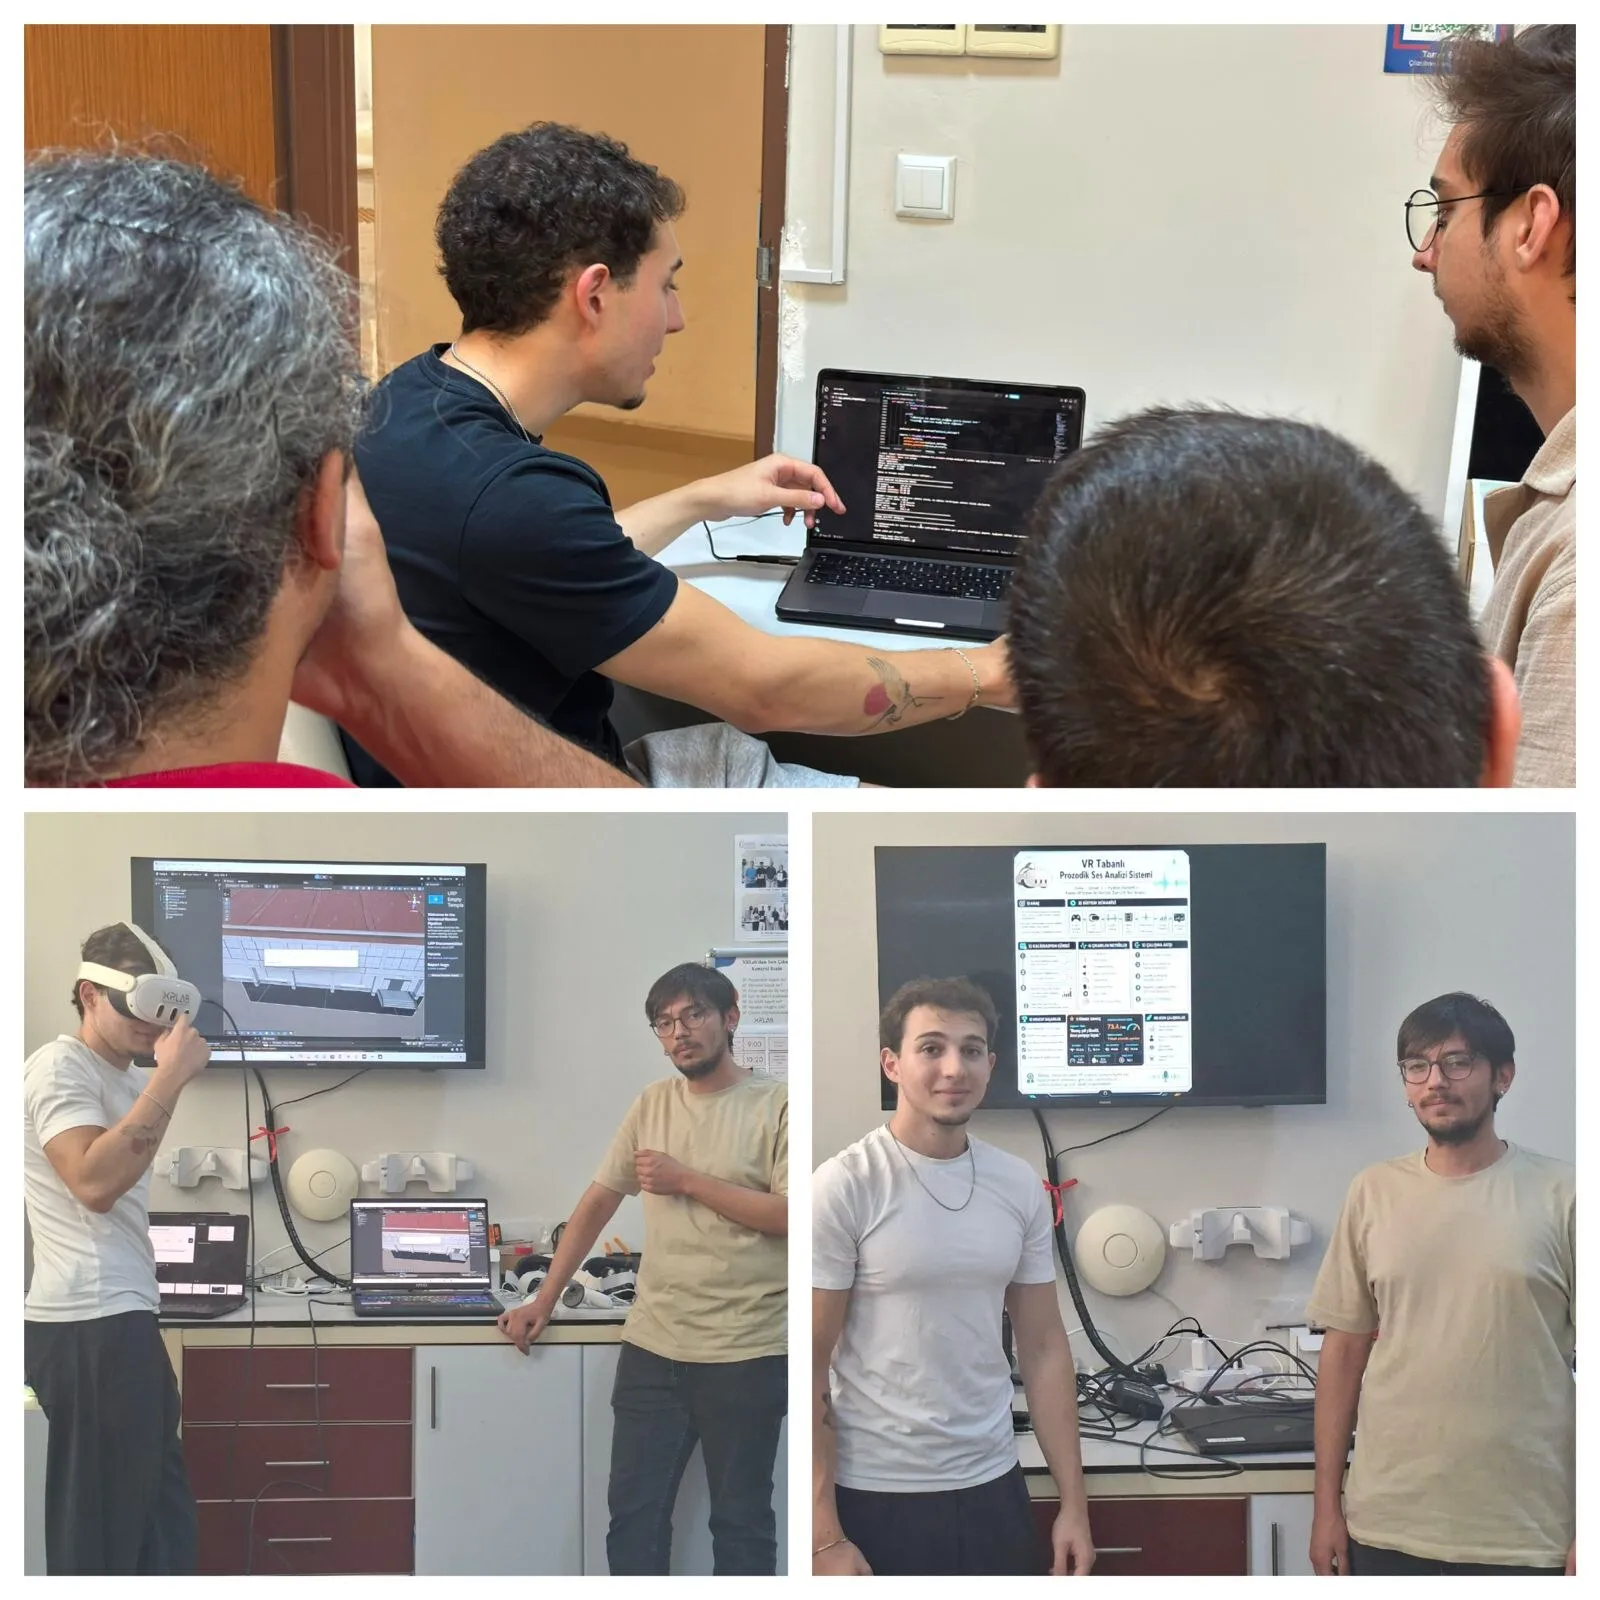
Analiz motoru başlık bağlı olmadan da çalışıyor. Geliştirirken bunu kullandım; test etmek de bu sayede kolay. Bir WAV dosyası ve bir cümle, tüm analiz sürecini çalıştırmaya yetiyor. VR katmanı yalnızca bir kaydı tetikliyor ve dönen sonucu gösteriyor.
Sınırlar ve kısıtlar
Prozodik puan, kişinin konuşmasının kendi sakin referansından aceleci referansına doğru ne kadar değiştiğini gösteriyor. Bu değişimin nedenini söylemiyor. Yorgunluk, nezle, gürültülü ortamda yüksek sesle konuşmak ve gerçekten acele etmek aynı özellikleri aynı yönde değiştirebiliyor. Ses sinyali bunları birbirinden ayırmaya yetmiyor. Puan açıkça klinik bir ölçüt değil. Kod, sonucu yazdırdığı yerde bunu söylüyor ve bu sistemin kullanılacağı her yerde söylemeye devam ederim. Konuşma hızını hesaplarken kullandığım hece sayısı, Türkçedeki ünlü harflerin sayısından elde edilen yaklaşık bir değer. Bir konuşmacıyı kendisiyle karşılaştırmak için yeterli, konuşmacıları birbiriyle karşılaştırmak için değil.
Projeyi destekleyen materyaller: Kaynak kodu · Mimari · Sistem tasarımı