F1 Race Result Prediction
Makine öğrenmesini, takip ettiğim Formula 1 üzerinden öğrendim. Geçmiş sonuçlarla bir sıralama modeli hazırlayıp bunu, girilen başlangıç sırasından yarış sonucunu tahmin eden bir uygulamaya dönüştürdüm.
Nedir Bir Formula 1 yarışının bitiş sırasını başlangıç gridinden tahmin eden, etkileşimli uygulama üzerinden kullanılan bir sıralama modeli.
Ne yaptım Veri işleme süreci, geçmiş sonuçlardan özellik çıkarımı, LightGBM sıralama modeli ve onu kullanan Streamlit uygulaması.
Benim rolüm
Yakından takip ettiğim bir konu üzerinden makine öğrenmesini öğrenmek için başladım. Ham tarihsel tablolardan çalışan uygulamaya kadar tüm aşamalarda çalıştım: veriyi hazırlayıp birleştirdim, güncel sezon verilerini toplayan scraper’ı ve geçmiş form özelliklerini hazırladım. Yarışın kendi sonucunu özelliklerinden ayırmak için kaydırma kullandım. Regresyon yerine sıralama modeli eğitmeyi seçtim. Başlangıç sırası girişi, yapıştırılan isim listesinin işlenmesi ve giriş kontrolleriyle Streamlit arayüzünü hazırladım.
01
Zaten önemsediğim bir konu
Bir yöntemi öğrenmenin en hızlı yolu, onu zaten ilgiyle takip edip tartıştığınız bir konuda denemek.
Formula 1 takip ediyorum ve beni bu alana en başta çeken şey arabalar ile mühendisliğin otomotiv tarafıydı. Makine öğrenmesini okumak yerine gerçekten öğrenmek istediğimde, başlamak için en doğal konu bu oldu. İyi bir cevabın neye benzediğini zaten biliyordum ve model bana saçma bir şey söylese hemen fark ederdim.
Bu, beklediğimden daha çok işe yaradı. Hataları yakalayan şey sporu bilmekti. Model, orta sıralarda yarışan bir araçtaki sürücüyü pole pozisyonuna koyduğunda, bir ölçüm yapmadan da terslik olduğunu görebiliyorum. Sonra nedenini araştırıyorum.
Cevabını aradığım soruyu somut ve sınırlı tuttum: belirli bir Grand Prix için bir başlangıç gridi verildiğinde, hangi bitiş sırasını beklemeliyiz?
02
Yetmiş beş yıllık sonuç, bir eğitim setine dönüştü
Formula 1’in geçmiş sonuçları düzenli kaydedilmiş, ama doğrudan model eğitiminde kullanılabilecek biçimde değil.
Tarihsel veri seti, birbiriyle ilişkili yarış, pist, sürücü, takım, sonuç, sıralama turu ve durum tablolarından oluşuyor. Kayıtlar 1950 yılına kadar uzanıyor. İşin büyük kısmı bu tabloları model eğitimine uygun hale getirmekti.
Sonuç ve yarış tabloları yarış kimliği üzerinden birleştiriliyor. Sıralama turlarında her sürücünün Q1 ile Q3 arasındaki en iyi derecesi seçiliyor. Ardından kayıtlar kronolojik sıraya konuyor; böylece geçmişe dayalı hesaplamalar doğru sırayla yapılıyor.
Güncel sezon geçmiş veri setinde yok, ben de onun için bir scraper yazdım. Şu ana kadar koşulmuş 2025 Grand Prix’lerinin Wikipedia sayfalarındaki yarış sınıflandırma tablolarını okuyor. Sürücü ve takım adlarının farklı yazımlarını aynı kimlik altında topluyor, sonuçları da tarihsel dosyalarla aynı biçimde kaydediyor.
Eğitim 1950’de değil 2021’de başlıyor. Sporun kuralları, araç konseptleri ve puan sistemleri o kadar çok değişti ki daha eski bir dönemden gelen bir sonuç başka bir sporu anlatıyor. Pencere sabit kodlanmak yerine veriden türetiliyor. Model son tamamlanmış sezona kadar eğitiliyor ve bir sonrakini tahmin ediyor; uygulamanın “2021 ile 2024 arası eğitim, 2025 tahmini” demesinin sebebi dosyaların içeriğinin bu olması.
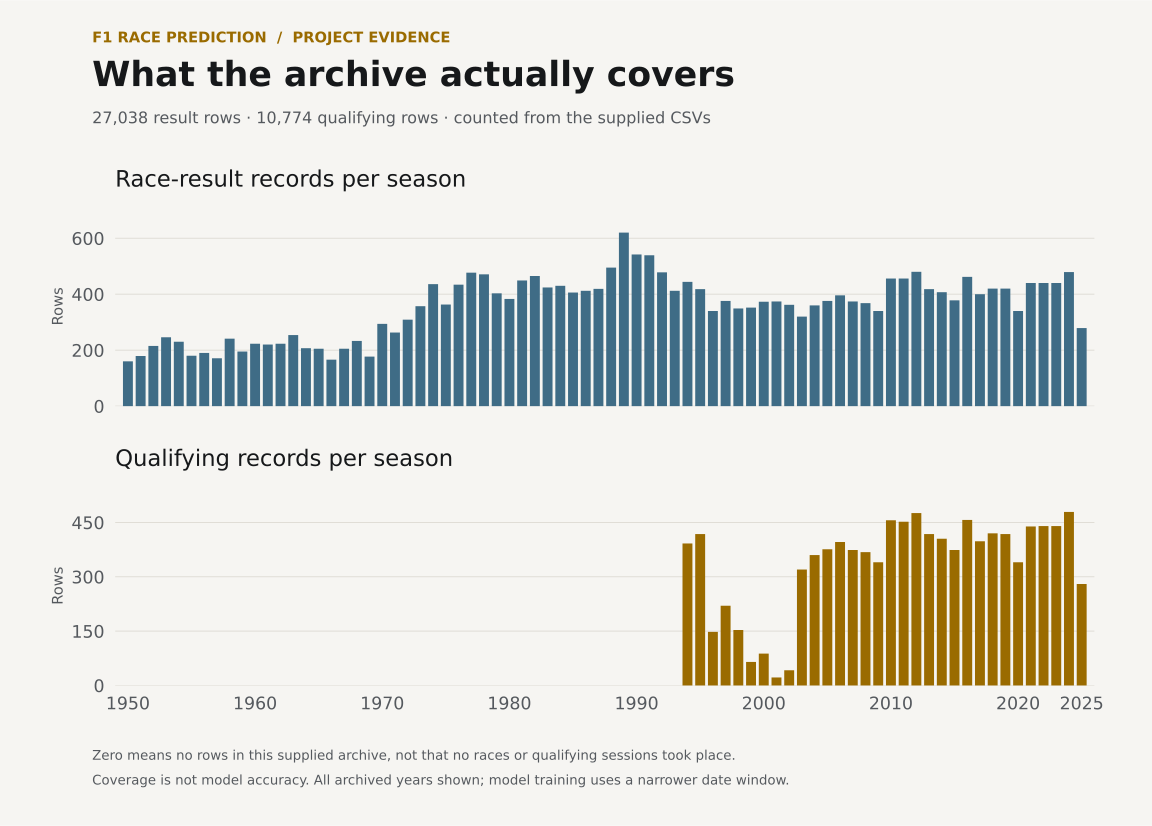
- Geçmiş sonuçlar 27,038 yarış sonucu, 1950 ile 2025 arası
- Sıralama turları 10,774 seans, yarış başına sürücü başına tek en iyi pozisyona indirgendi
- Eğitim penceresi 2021 ile son tamamlanmış sezon arası
- Güncel sezon Yarış başına Wikipedia sınıflandırma tablolarından toplanıyor
- Hedef Learning to rank: LightGBM lambdarank, ndcg, yarış bazında gruplanmış
03
Yarış başlamadan önce bilinenlerle tahmin yapmak
Bir spor modelinde asıl zor kısım algoritmayı seçmek değil, girdilere yarış sonucunun sızmasını önlemek.
Bir sürücünün son dönemdeki formu, elde bulunan en faydalı tek sinyal ve aynı zamanda mükemmel görünen ama hiçbir işe yaramayan bir model kurmanın en kolay yolu. Bir sürücünün bitiş pozisyonunun hareketli ortalaması bu yarışı da içeriyorsa, öznitelik etiketi barındırıyor demektir ve model cevabı oradan okumayı öğrenir.
Dört form özniteliği bunun olamayacağı şekilde kuruluyor. Her biri son üç bitiş pozisyonunun hareketli ortalaması ve her biri önce bir yarış kaydırılıyor; böylece bir yarışa iliştirilen değer kesinlikle ondan önceki yarışlardan hesaplanıyor:
app.py · build_training_table()
df["drv_last3_mean"] = (
  df.groupby("driverId")["positionOrder"]
      # shift(1) first: this race cannot see its own result
    .transform(lambda s: s.shift(1).rolling(3, min_periods=1).mean())
)
Kaydırma, hareketli pencereden önce geliyor; böylece bir yarış kendi özniteliğine hiçbir zaman katkı vermiyor.
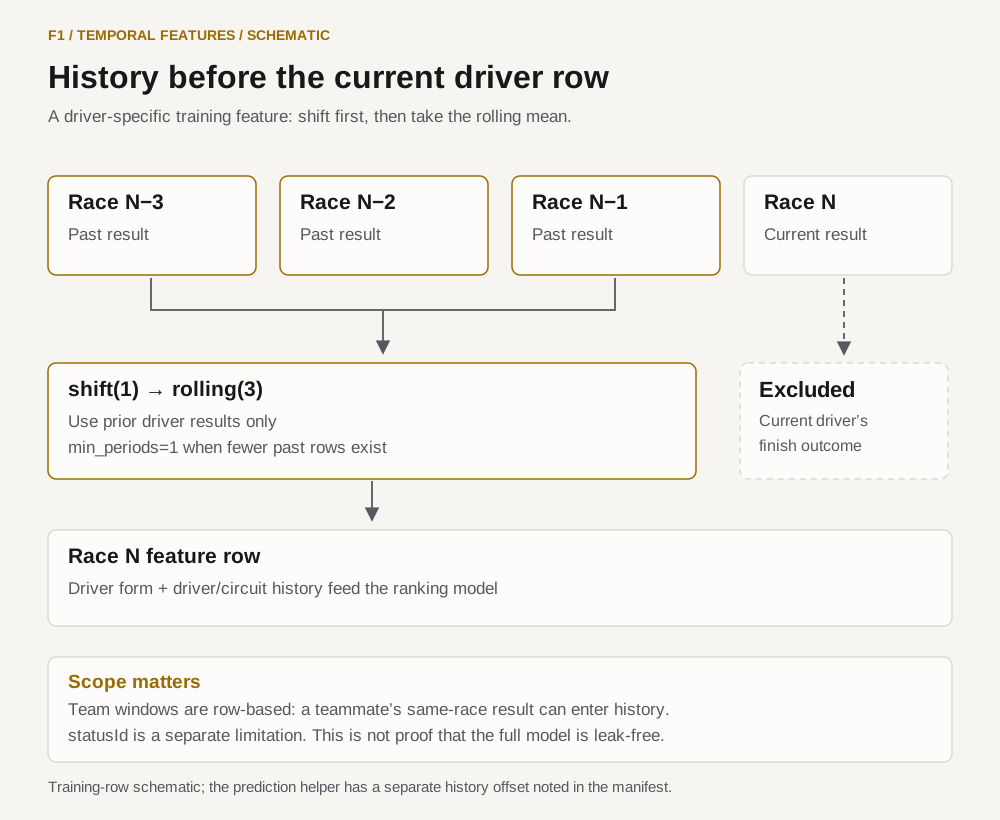
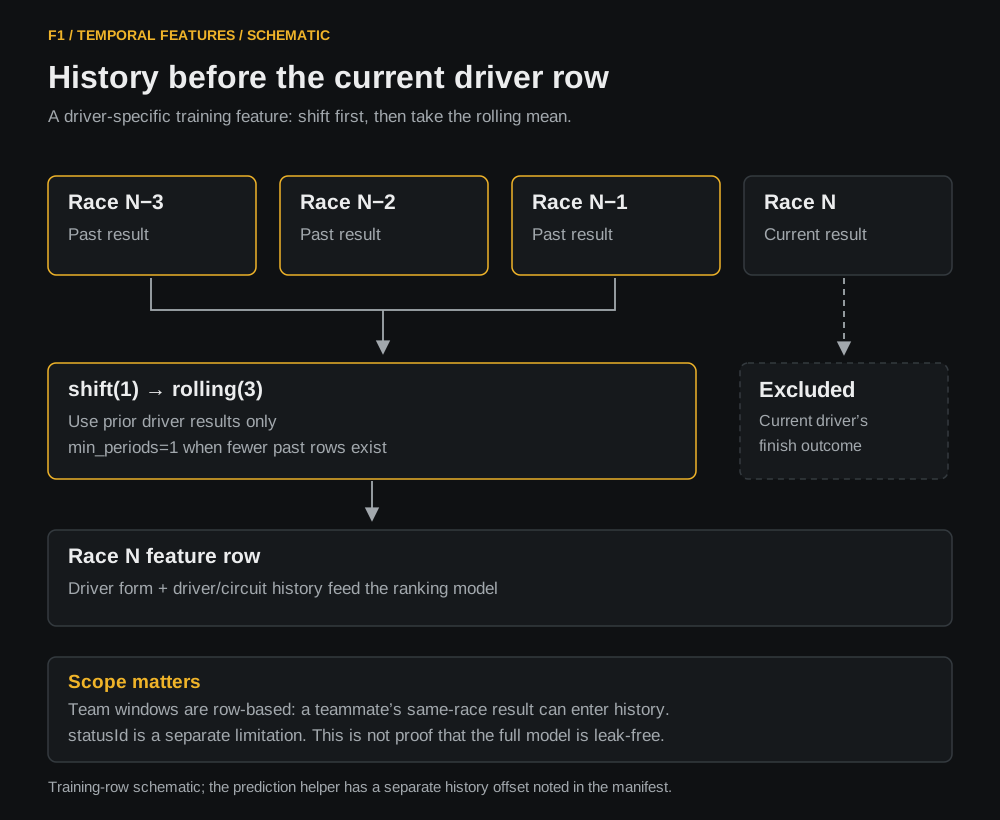
Aynı yöntemle formu dört açıdan hesaplıyorum: sürücünün genel formu ve seçilen pistteki formu, takımın genel formu ve aynı pistteki formu. Monaco ve Monza farklı araç özelliklerini öne çıkarıyor. Bu yüzden bir takımın genel formu ile belirli bir pistteki formu aynı şeyi anlatmıyor.
İkinci karar, modelin ne öğrenmesi gerektiğiydi. Bitiş pozisyonunu düz bir sayı olarak tahmin etmek,
birinci ile ikinci arasındaki farkı on beşinci ile on altıncı arasındaki farkla
aynı sayar ve tam olarak tek bir arabanın birinci bitebileceğinden habersizdir.
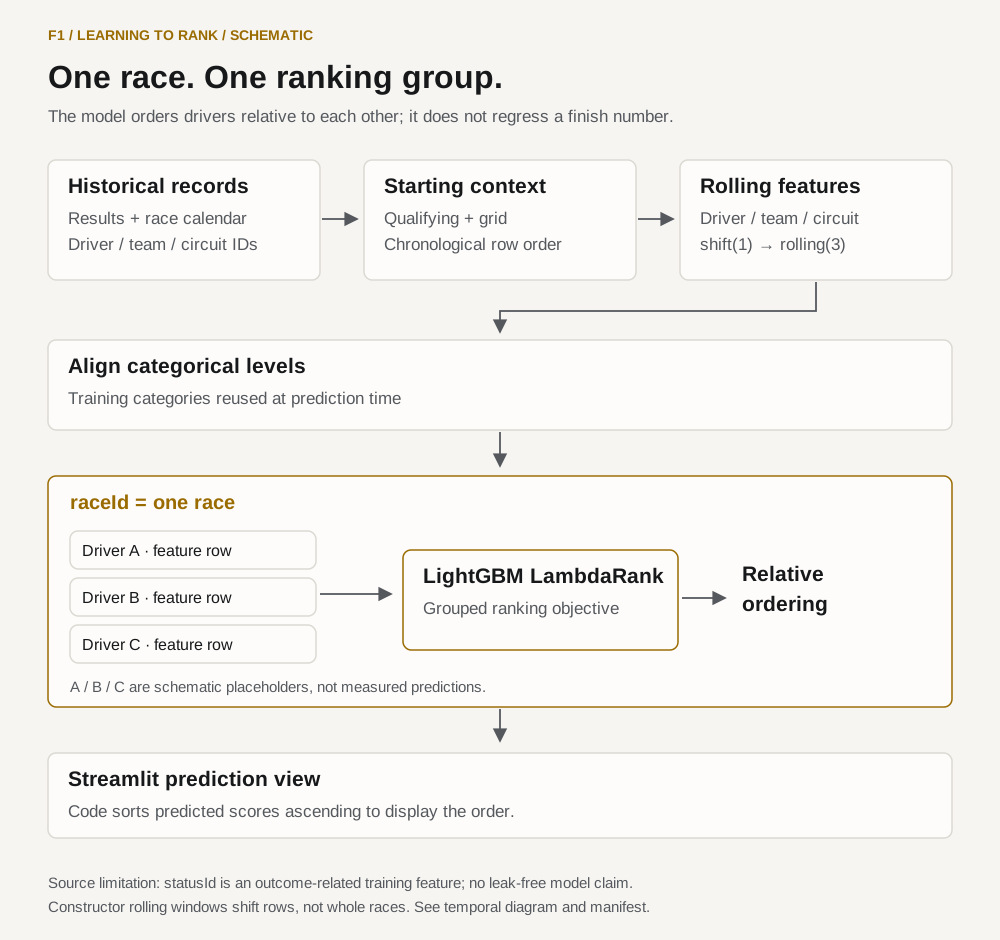
Bu yüzden model bunun yerine sıralama yapmak üzere eğitiliyor: LightGBM’in
lambdarank hedefi, satırlar yarış bazında gruplanmış halde. Böylece her yarış
tek bir sıralama problemi oluyor ve model, sürücü başına mutlak hata yerine o
yarışın içinde ürettiği sıra üzerinden puanlanıyor.
Projeyi değerlendirirken model için yaklaşık %82 doğruluk kaydetmiştim. Bunu o çalışmanın sonucu olarak aktarıyorum; belgelenmiş bir protokolle yeniden üretilmiş bir benchmark olarak değil. Elimdeki materyallerde metriğin tanımı ve doğrulamanın nasıl yapıldığı yazmıyor. Bir sayıyı doğru değerlendirebilmek için nasıl elde edildiğini de bilmek gerekiyor.
04
Eğitilmiş modeli kullanılabilir bir uygulamaya dönüştürmek
Notebook’taki model, önceden hazırladığınız soruları yanıtlıyor. Uygulama ise yeni girdilerle yeni tahminler yapmanızı sağlıyor.
Son adım, eğitilmiş modeli başlangıç sırası girilebilen bir uygulamaya dönüştürmekti. Uygulama CSV’leri yüklüyor, eğitim tablosunu kuruyor, sıralayıcıyı bir kez eğitip önbelleğe alıyor, sonra bir Grand Prix, bir sürücü sayısı ve doldurulacak yirmi pozisyon sunuyor.
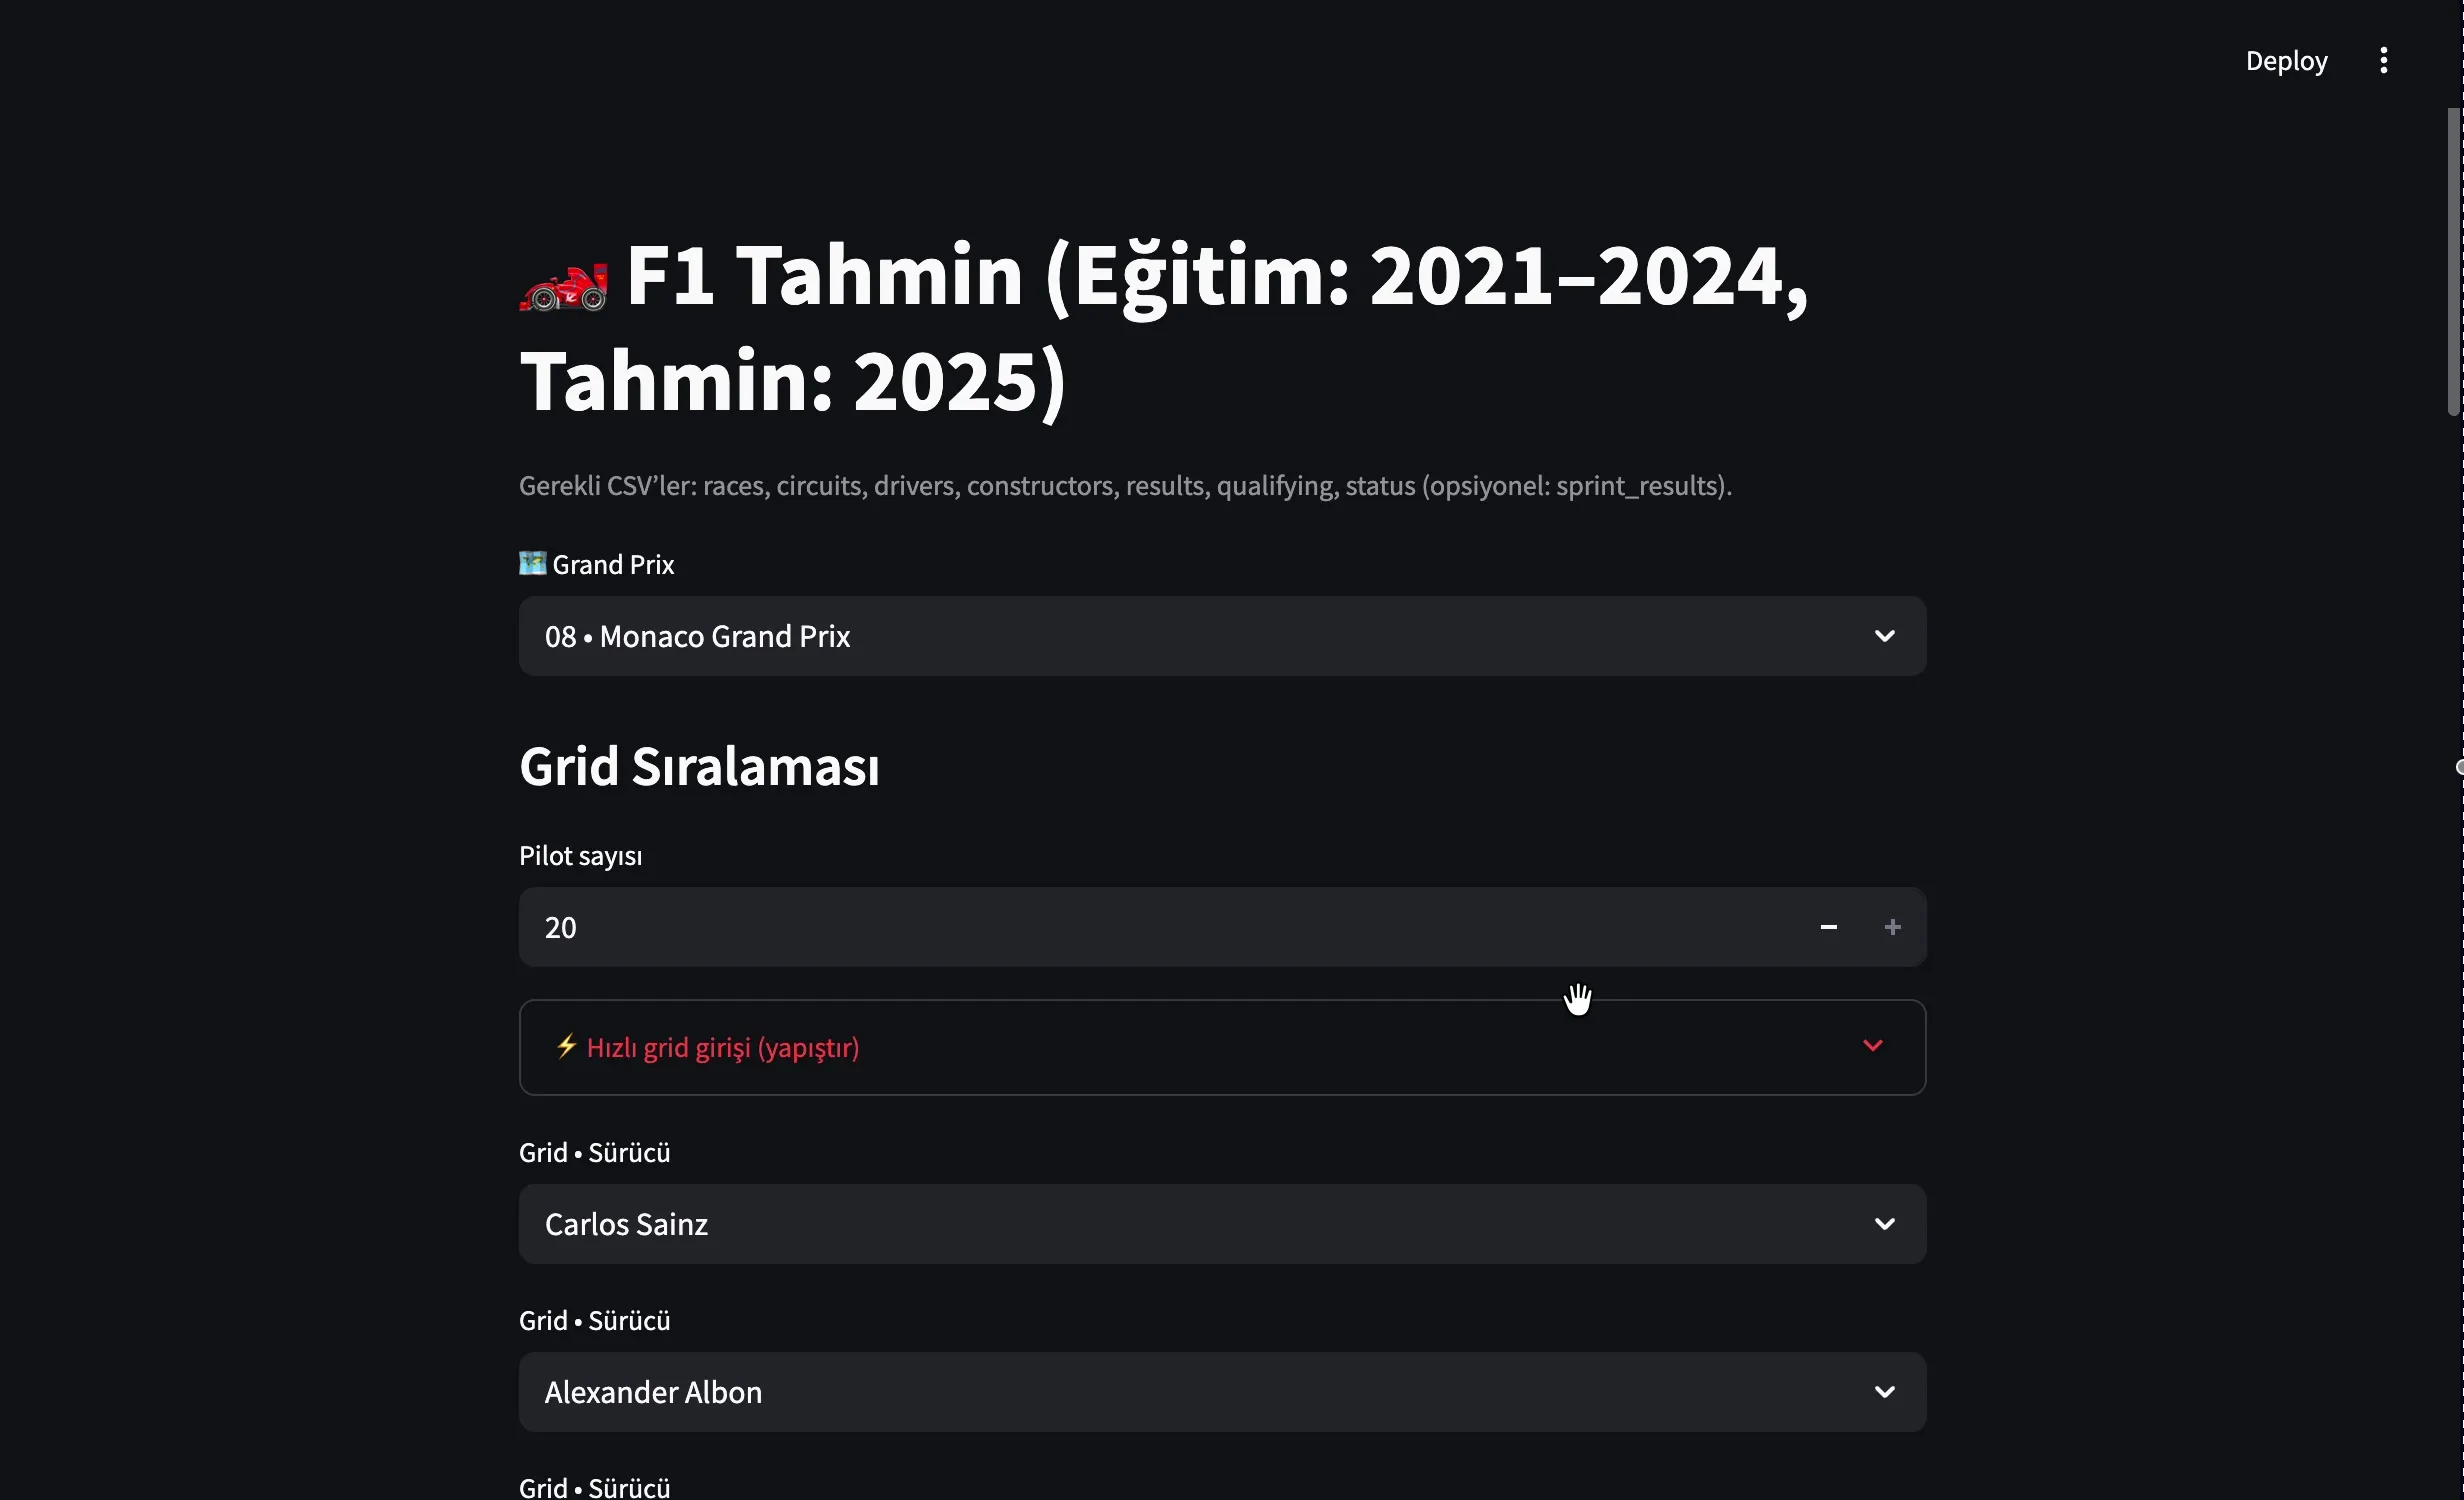
Yirmi açılır menüyü elle doldurmak hemen sıkıcı hale geliyor, bu yüzden bir yapıştırma kutusu var: her satıra bir isim gelecek şekilde bir liste bırakıyorsunuz, ilk satır pole. Türkçe karakterleri normalize ediyor, böylece Türkçe klavyede yazılan isimler de eşleşiyor ve tam ad eşleşmezse soyadını kullanarak eşleştirmeyi deniyor. Aynı sürücü iki kez görünüyorsa tahmin etmeyi reddediyor; bu, insanın ancak kendi başına geldikten sonra eklediği türden bir şey.
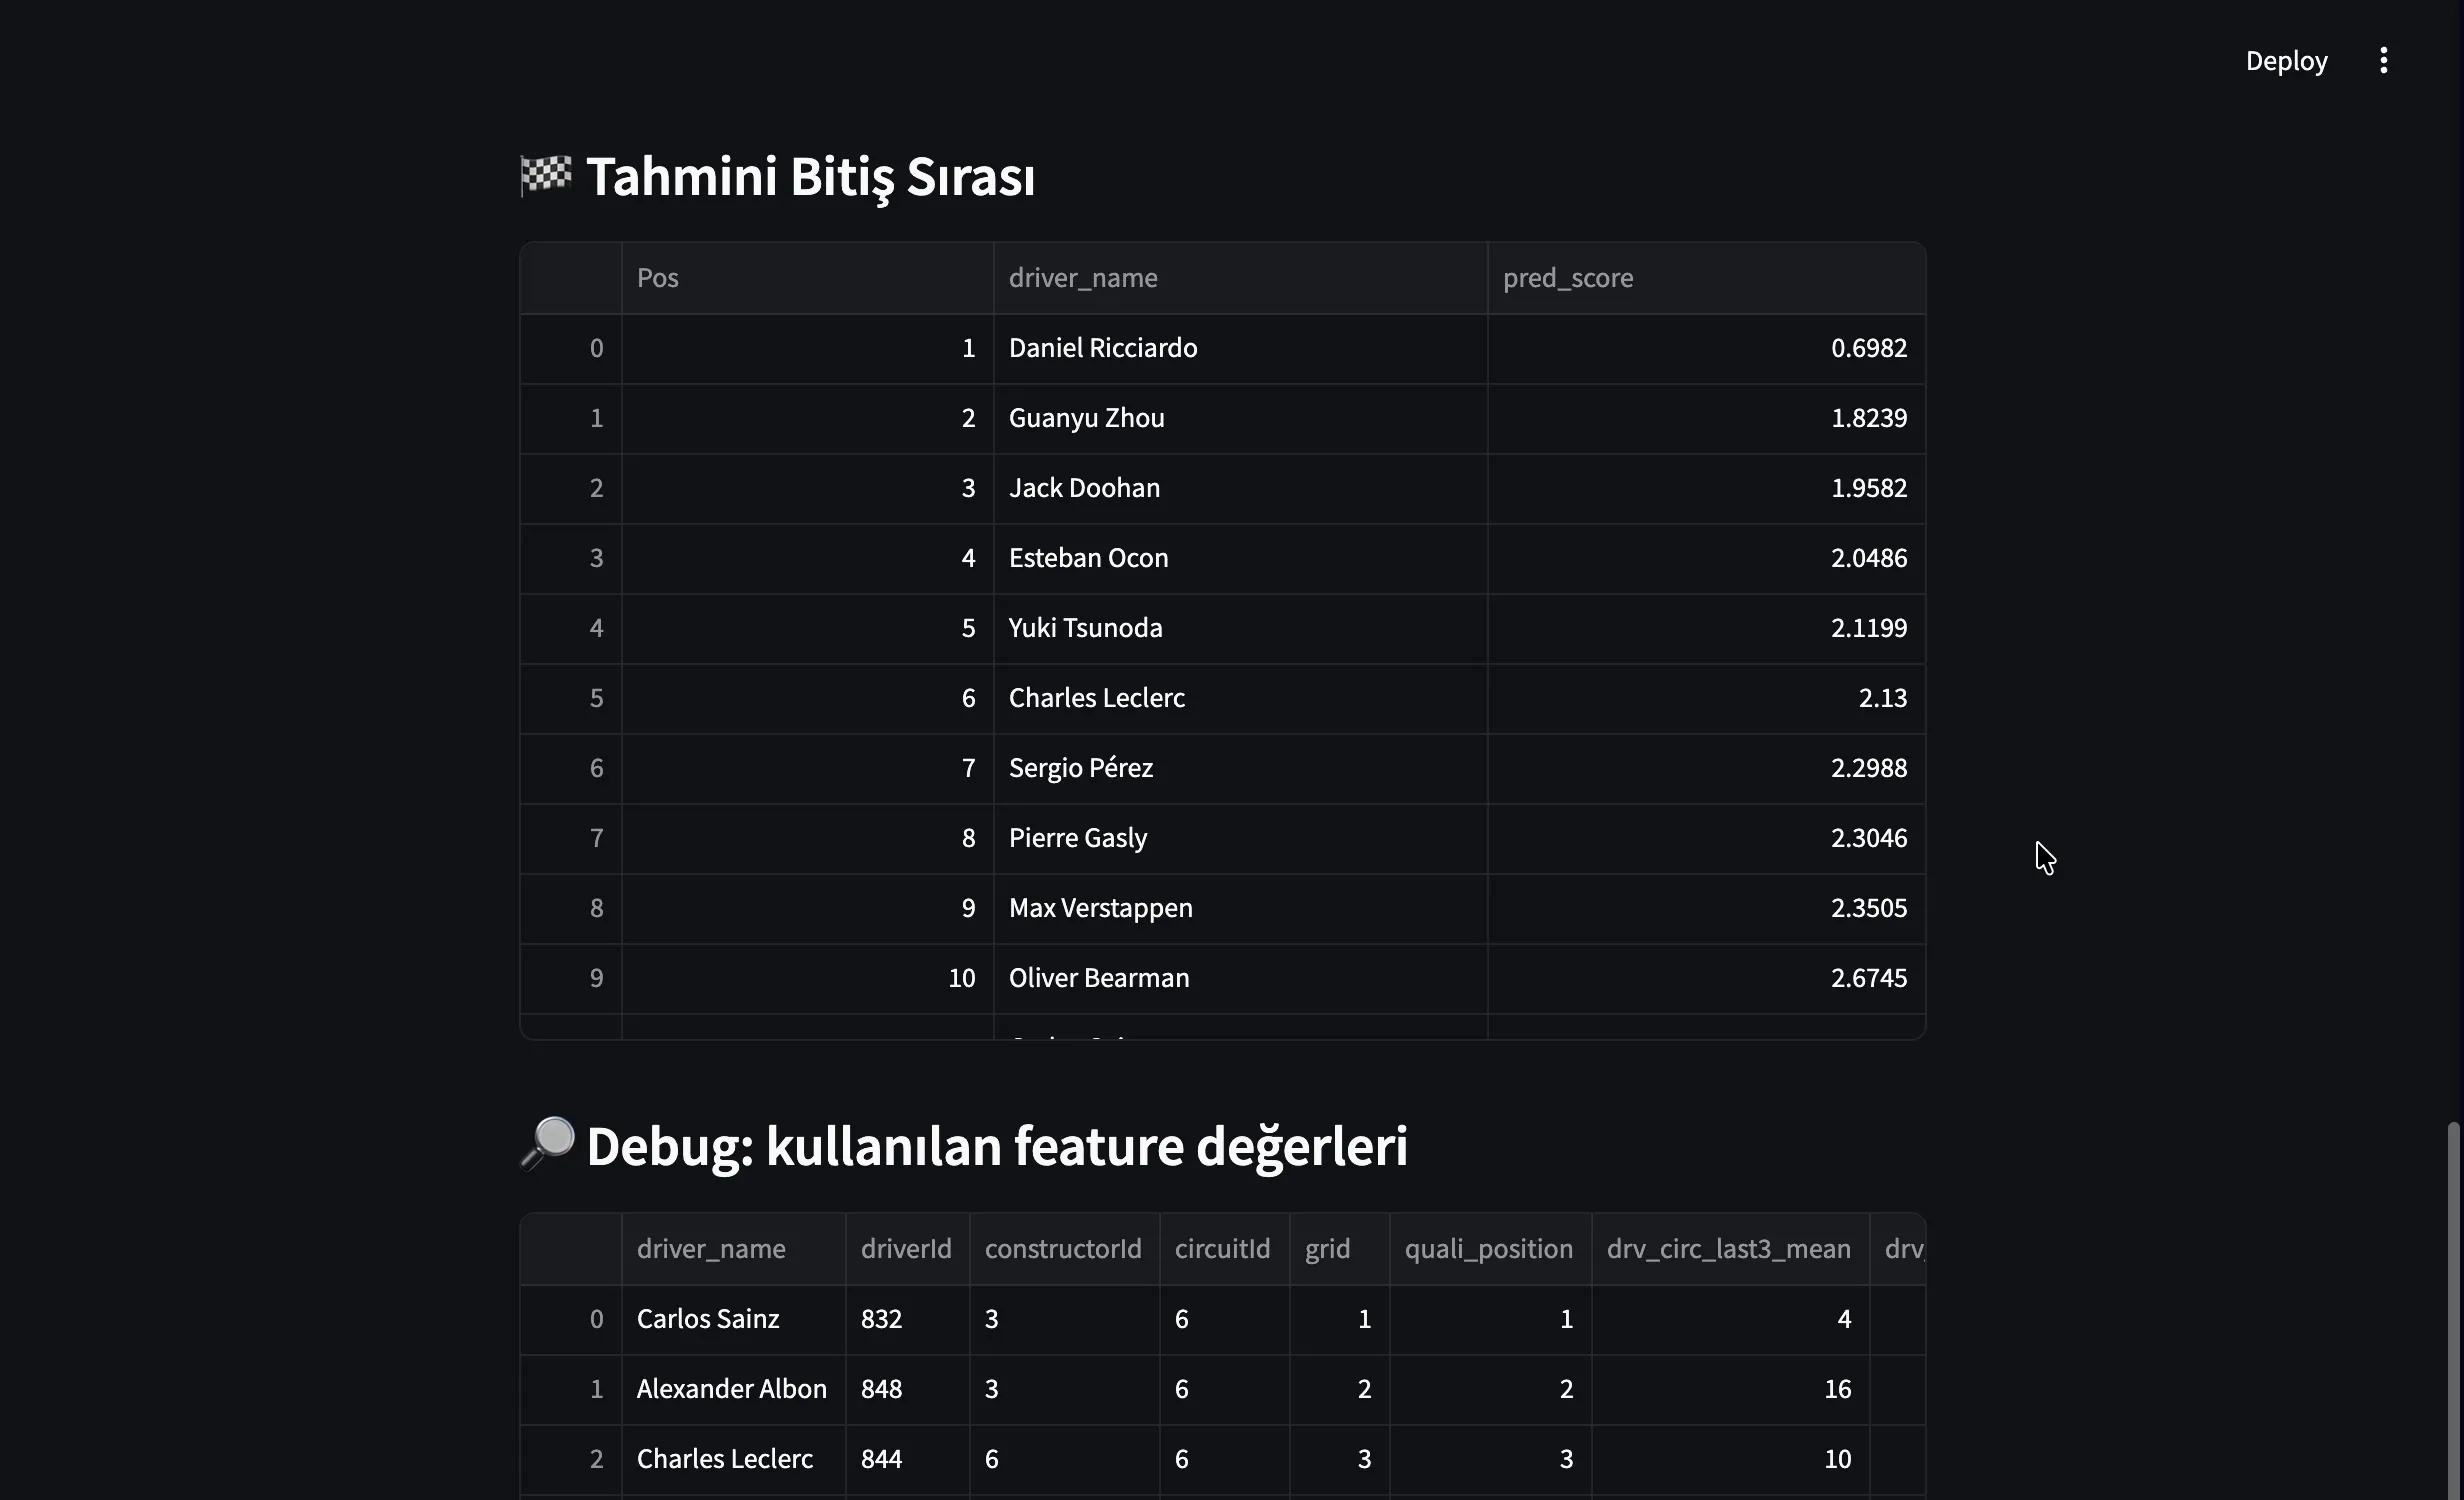
Uygulama, başlangıç sırasındaki her sürücünün güncel takımını buluyor; bu sezon yarıştıysa bu sezonu, yarışmadıysa en son sezonunu kullanıyor. Dört form özniteliğini seçilen piste göre yeniden hesaplıyor, kategorileri eğitimde kullanılanlarla eşleştirip modelden bir skor alıyor. Sürücüleri bu skora göre sıralayarak tahmini oluşturuyor.
Tamamlanan uygulama ne yapıyor
- Geçmiş yarış, sıralama turu, sürücü, takım ve pist tablolarını yüklüyor ve birleştiriyor
- Eğitim ve tahmin sezonlarını bir sabitten değil, veriden türetiyor
- Her biri bir yarışın kendi sonucunu görememesi için kaydırılmış dört hareketli form özniteliği kuruyor
- Satırları yarış yarış gruplayarak bir LightGBM lambdarank modeli eğitiyor
- Başlangıç sırasını açılır menülerden veya yapıştırılan listeden alıyor; aynı sürücünün iki kez girilmesini engelliyor
- Her sürücüyü güncel bir takıma bağlıyor ve formunu seçilen pist için yeniden hesaplıyor
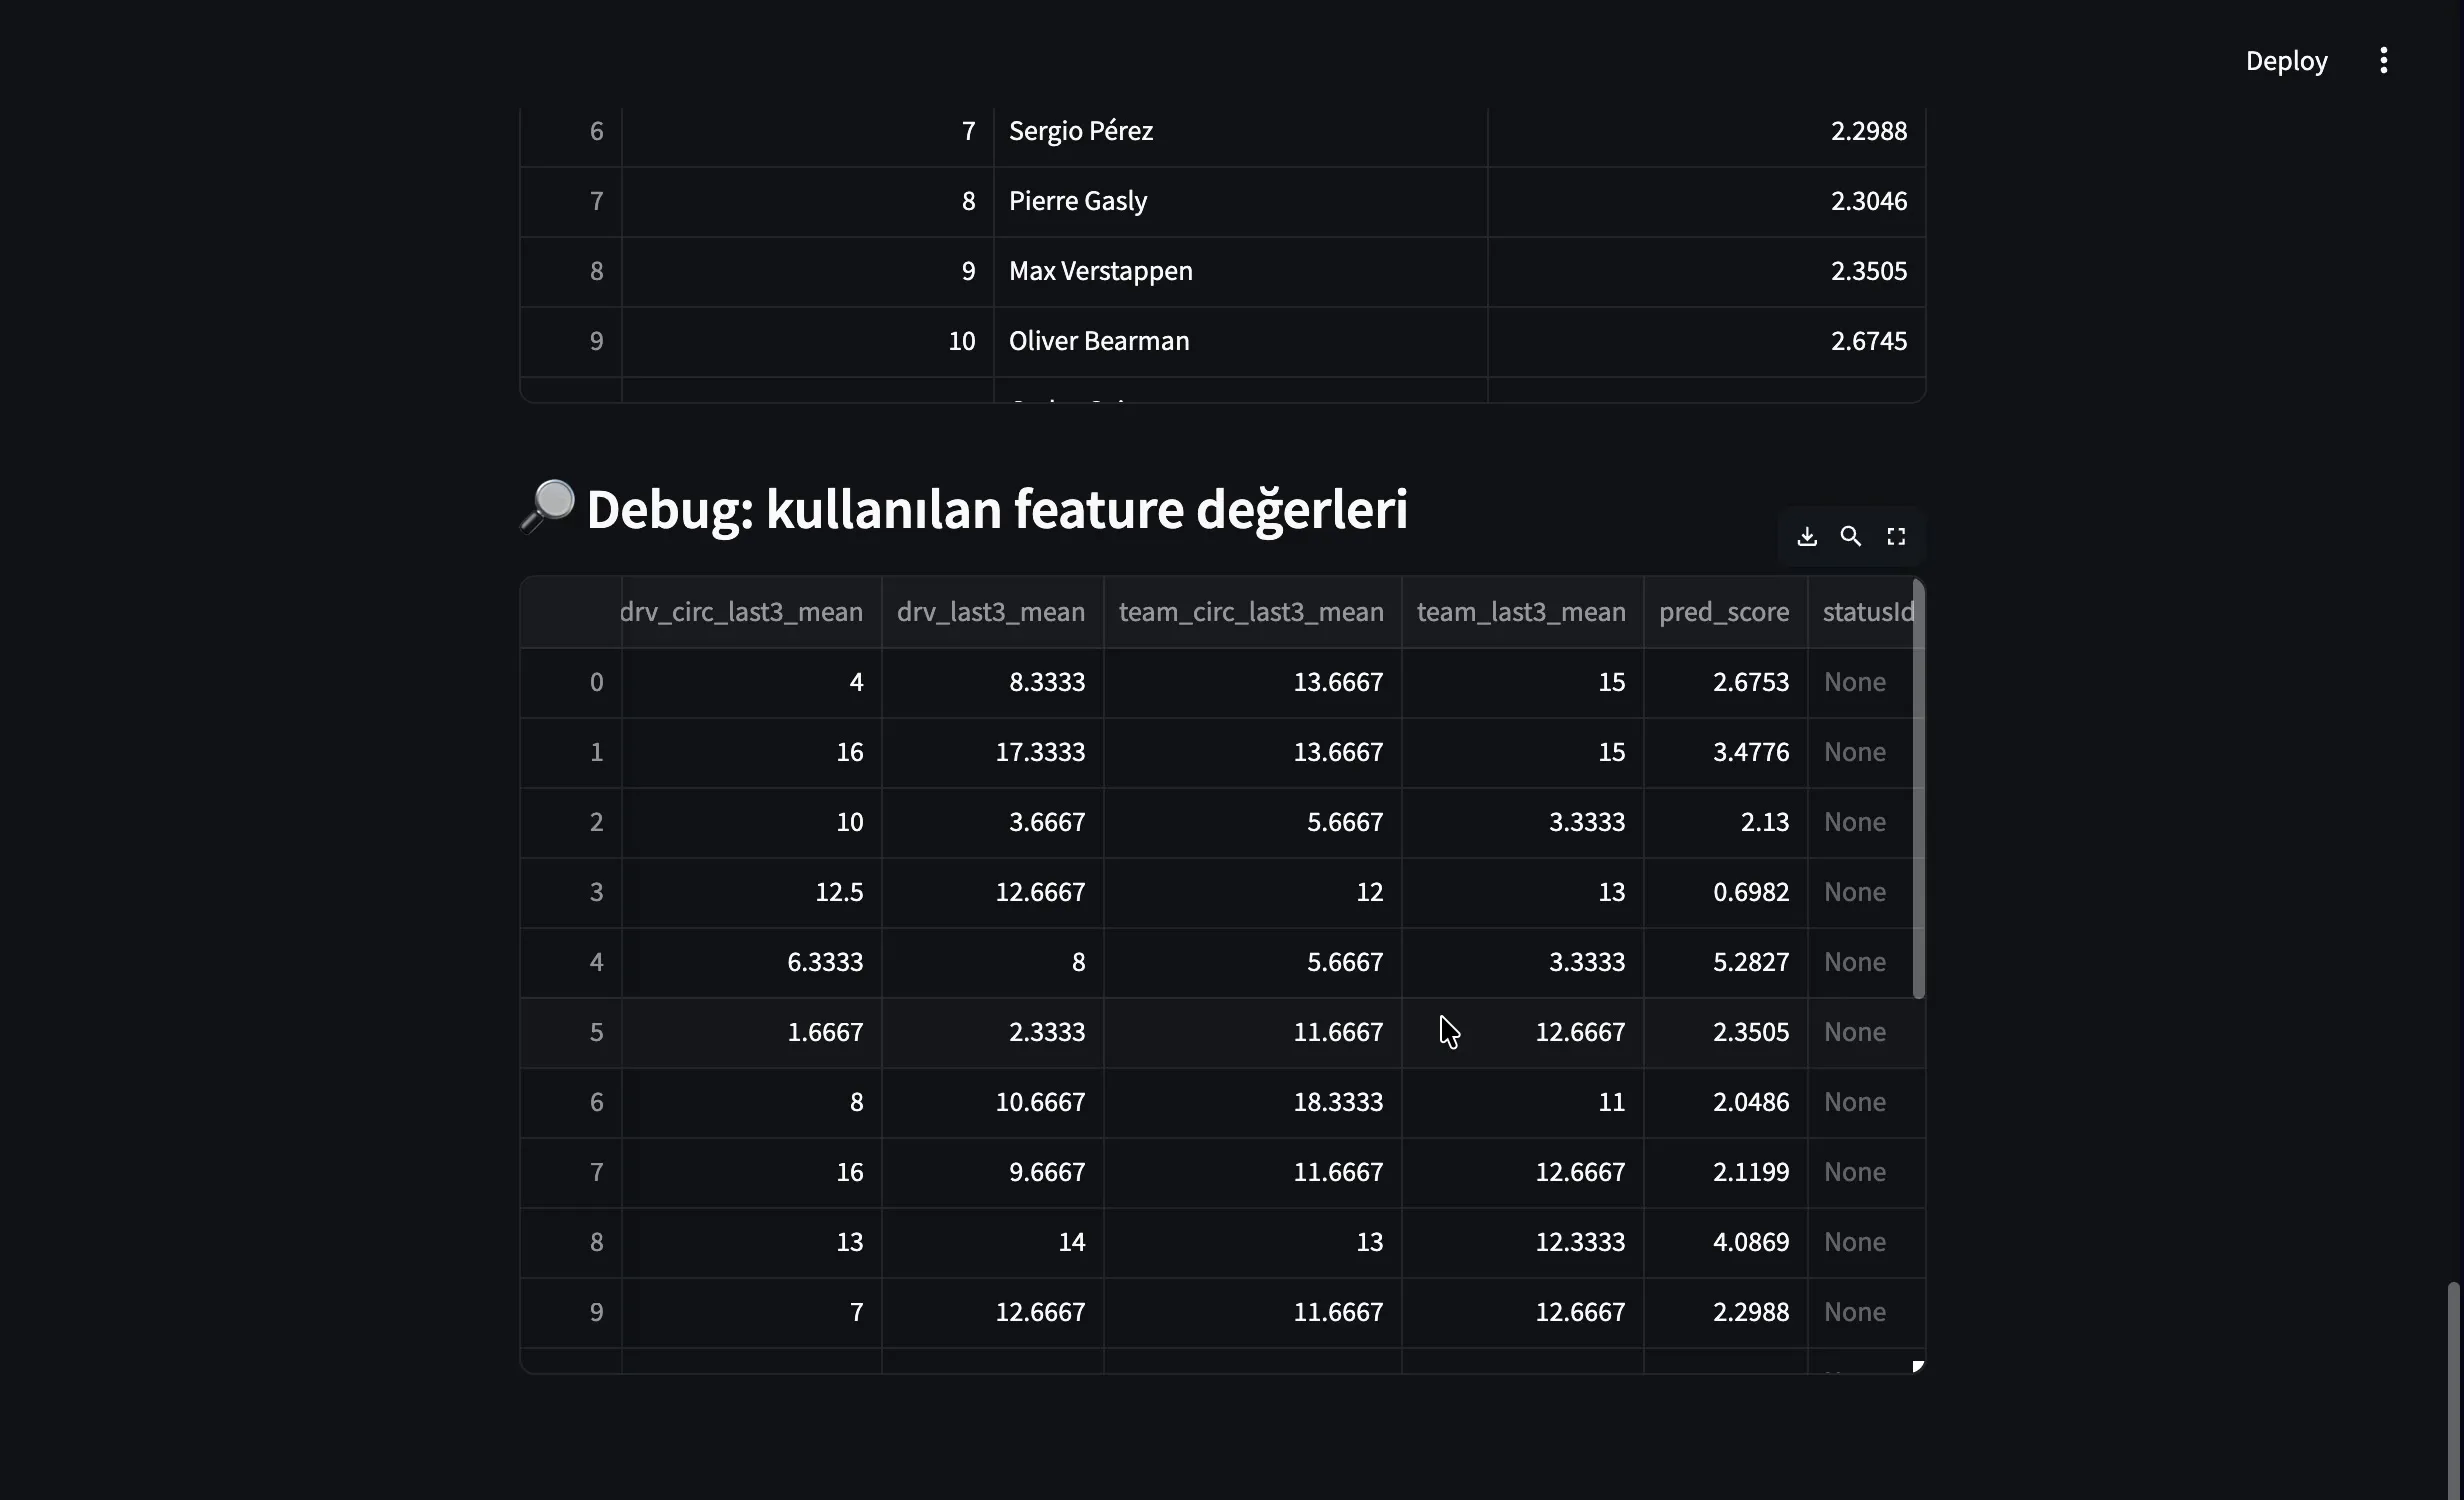
- Tahmin edilen bir bitiş sırası döndürüyor ve arkasındaki her öznitelik değerini gösterebiliyor
Sınırlar ve kısıtlar
Modelin önemli bir kısıtı var. Öznitelik listesi hâlâ, bir aracın bitirip bitirmediğini, terk mi ettiğini yoksa kaza mı yaptığını kaydeden yarış durum kodunu içeriyor. Bu, yarışın bir sonucu ve yarıştan önce bilinebilecek bir şey değil; tahmin anında ise basitçe boş bırakılıyor. Geçmiş form özellikleri bu sızıntıya karşı korunuyor; sıralama turu sonuçları ve başlangıç sırası da yarıştan önce biliniyor. Yine de durum sütunu çıkarılıp model yeniden eğitilmeden tüm veri işleme sürecinin sızıntısız olduğunu söylemem. Bunun ötesinde model hava durumu, lastik stratejisi, güvenilirlik, güncellemeler ya da sezon ortası sürücü değişiklikleri hakkında hiçbir şey bilmiyor. Gördüğü tek şey bir grid ve bitiş pozisyonlarının geçmişi.
Projeyi destekleyen materyaller: Kaynak kodu · Üretilen çıktı